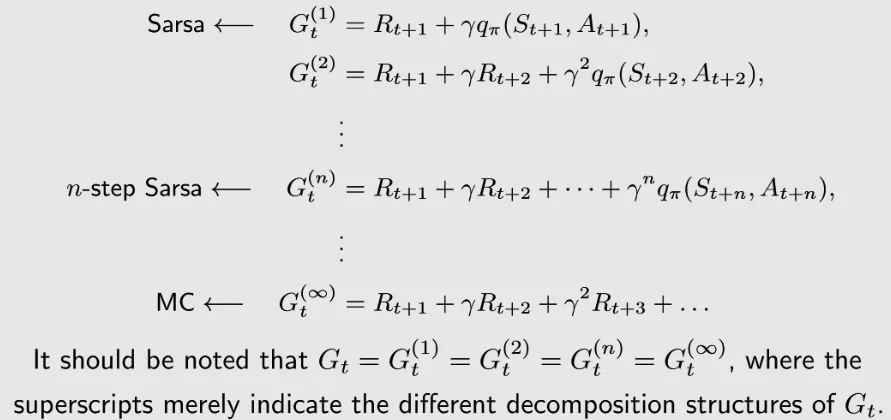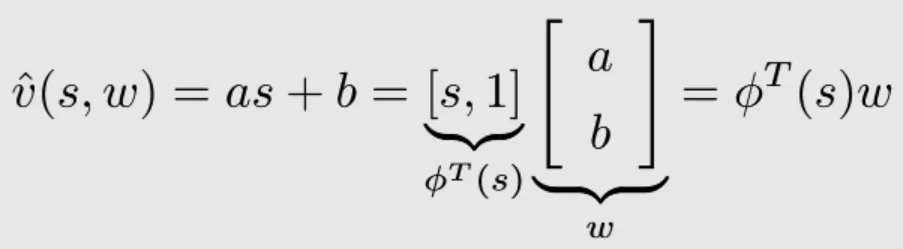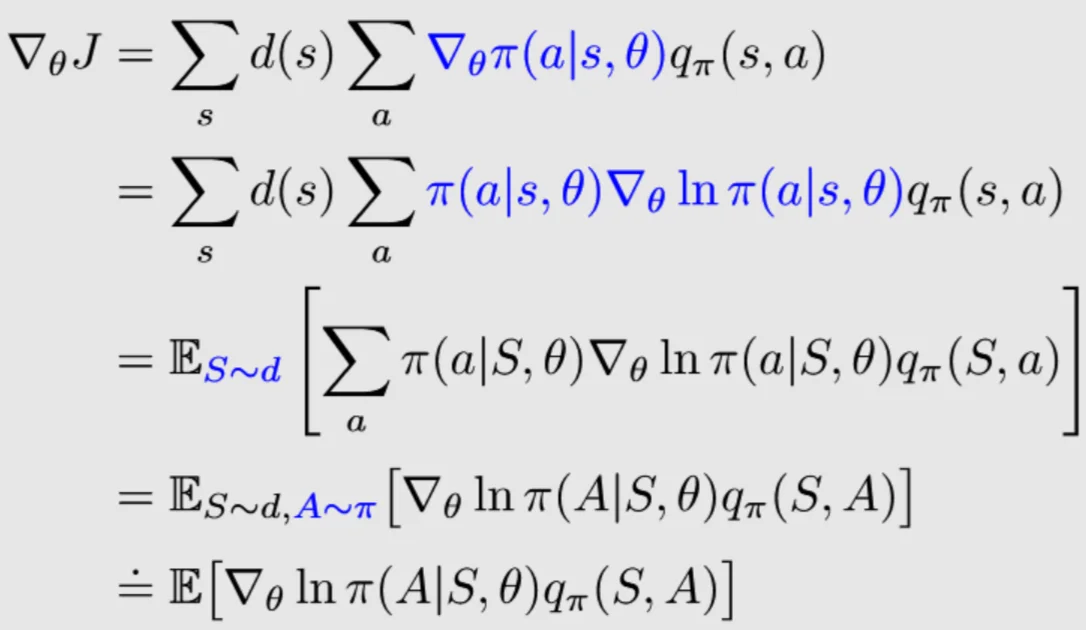数学基础
全概率公式 :“把所有可能的原因各自的发生概率,乘上它们各自导致结果的概率,再加起来,就是结果的总概率。”
把 “结果 A A A B 1 、 B 2 、 … 、 B n B₁、B₂、…、Bₙ B 1 、 B 2 、 … 、 B n A A A
P ( A ) = ∑ i = 1 n P ( B i ) P ( A ∣ B i ) \boxed{P(A)=\sum_{i=1}^{n}P(B_i)\,P(A\mid B_i)} P ( A ) = i = 1 ∑ n P ( B i ) P ( A ∣ B i )
贝叶斯公式 :“看到结果后,把原因的初始可信度按谁更能解释这个结果重新加权,就是贝叶斯。”
先猜:不管结果,原因 B i B_i B i P ( B i ) P(B_i) P ( B i )
再看:如果真是 B i B_i B i A A A P ( A ∣ B i ) P(A|B_i) P ( A ∣ B i )
最后把每条原因的先验 × 似然加起来当总蛋糕,把 B i B_i B i B i B_i B i
先验 × 似然 ÷ 总蛋糕 = 后验
P ( B i ∣ A ) = P ( B i ) P ( A ∣ B i ) ∑ j P ( B j ) P ( A ∣ B j ) \boxed{P(B_i|A)=\frac{P(B_i)\,P(A|B_i)}{\sum_j P(B_j)\,P(A|B_j)}} P ( B i ∣ A ) = ∑ j P ( B j ) P ( A ∣ B j ) P ( B i ) P ( A ∣ B i )
大数定律 :当同一个随机实验重复很多次时,实际结果的平均值会越来越接近理论上的期望值。
lim n → ∞ 1 n ∑ i = 1 n X i = E [ X ] \boxed{\lim_{n \to \infty} \frac{1}{n} \sum_{i=1}^n X_i = \mathbb{E}[X]} n → ∞ lim n 1 i = 1 ∑ n X i = E [ X ]
当独立重复试验的次数 n n n 1 n ∑ i = 1 n X i \displaystyle \frac{1}{n}\sum_{i=1}^n X_i n 1 i = 1 ∑ n X i E [ X ] \mathbb E[X] E [ X ]
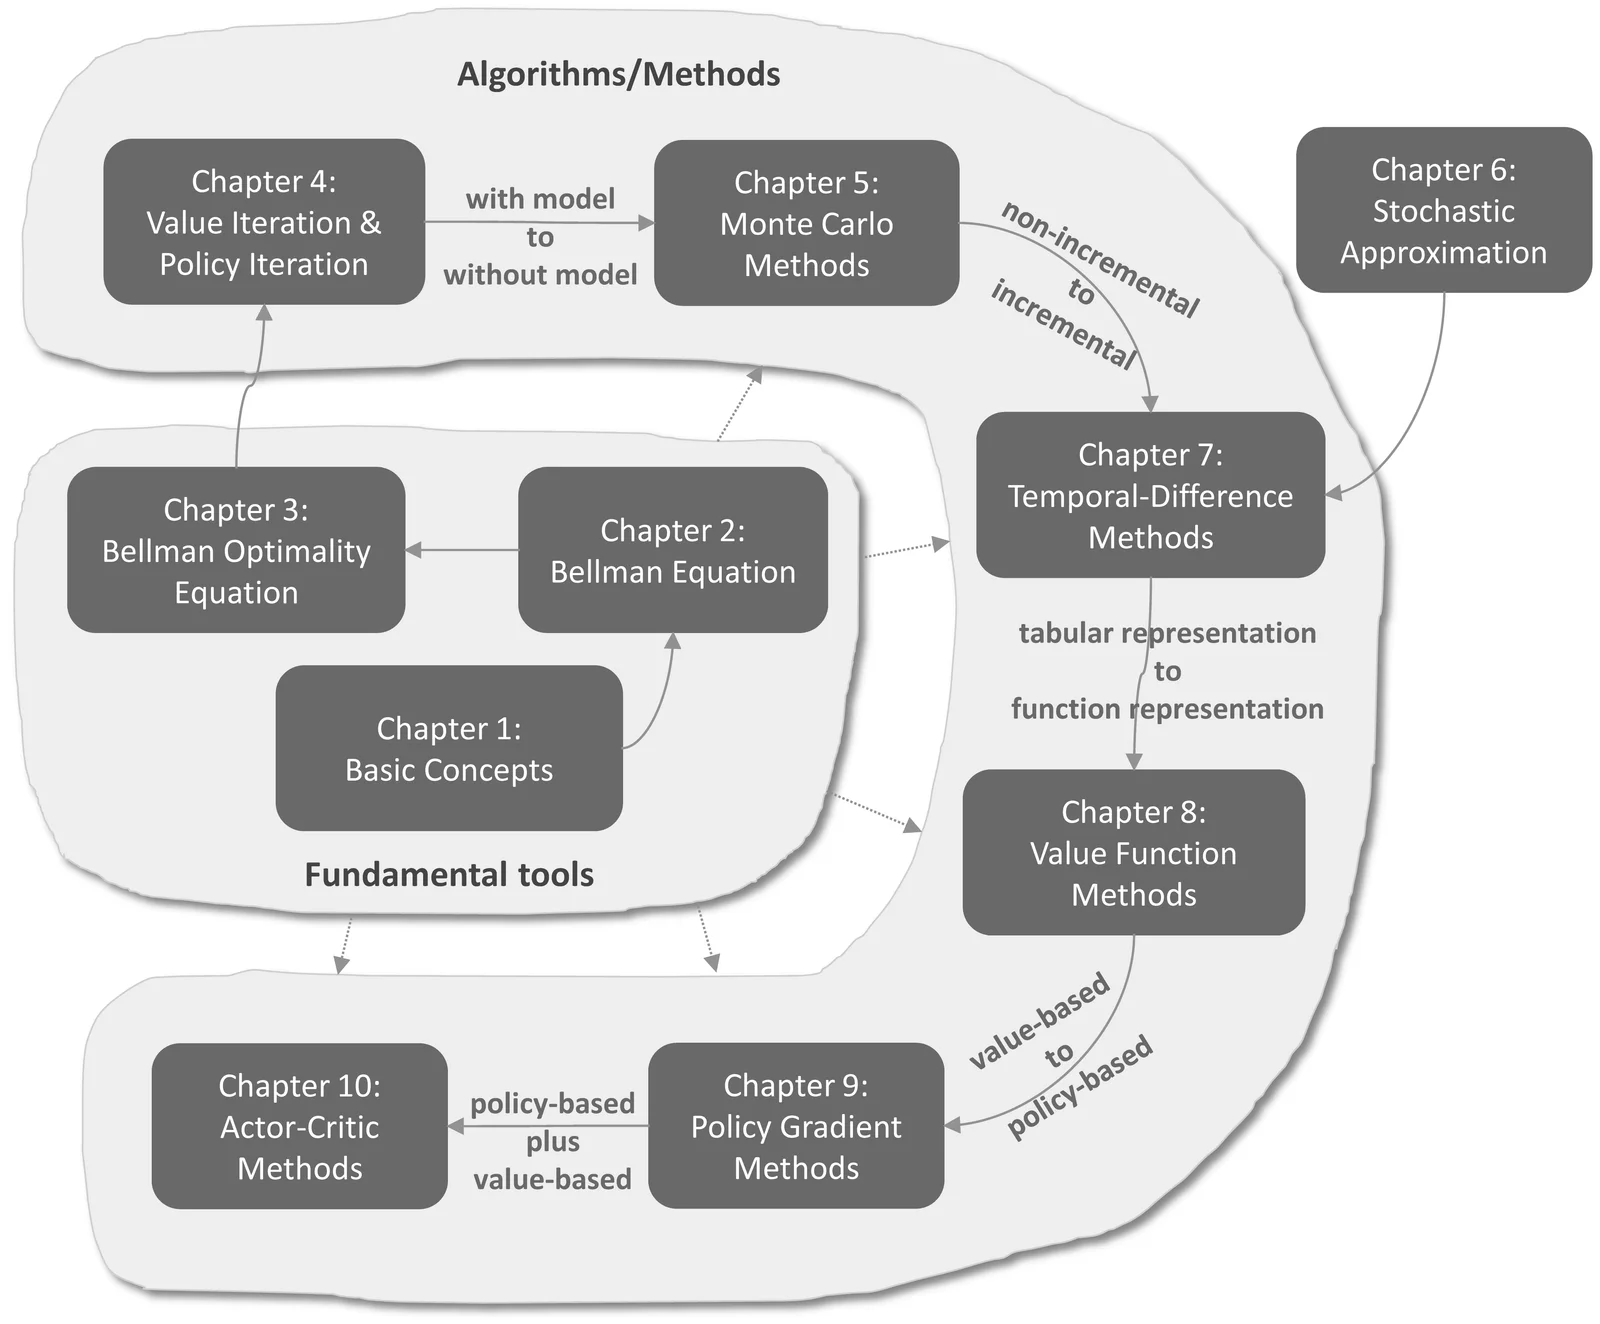
Roadmap
🔺Fundamental Tools
🟡基本概念(Basic Concepts)
(How to define “good” )
这需要我们找到最优的策略
Markov Decision Process(马尔可夫决策过程) :MDP 描述了一个智能体在随机环境里“做什么动作、得到什么回报、世界怎么变化”的完整规则
MDP概念:
状态(state)、动作(action)、奖励(reward)
状态转移概率(State transition probabilit): p ( s ′ ∣ s , a ) p(s'|s, a) p ( s ′ ∣ s , a )
奖励概率(Reward probabilit): p ( r ∣ s , a ) p(r|s, a) p ( r ∣ s , a )
(Markov property: memoryless property )
Markov property: memoryless property 无记忆性
马尔可夫性质:与历史无关(memoryless)
🟡贝尔曼方程(Bellman Equation)
基本形式
每个状态 S t S_t S t π \pi π R t + 1 R_{t+1} R t + 1 S t + 1 S_{t+1} S t + 1 γ G t + 1 \gamma G_{t+1} γ G t + 1
v π ( s ) = E [ R t + 1 + γ G t + 1 ∣ S t = s ] = ∑ a π ( a ∣ s ) ∑ s ′ , r ( s ′ , r ∣ s , a ) [ r + γ v π ( s ′ ) ] , ∀ s ∈ S v_π(s) = \mathbb{E}[R_{t+1} + γG_{t+1} | S_t=s] = \sum_{a} \pi(a|s) \sum_{s',r}(s',r|s,a)[r + γ v_π (s')], ∀s∈S v π ( s ) = E [ R t + 1 + γ G t + 1 ∣ S t = s ] = ∑ a π ( a ∣ s ) ∑ s ′ , r ( s ′ , r ∣ s , a ) [ r + γ v π ( s ′ )] , ∀ s ∈ S
贝尔曼方程描述了不同状态之间的值函数的关系。给定策略后求解贝尔曼方程的过程也称之为策略评估(Policy Evaluation)。
比如有两个策略 π 1 \pi_1 π 1 π 2 \pi_2 π 2 s ∈ S s\in \mathcal {S} s ∈ S v π 1 ( s ) ≥ v π 2 ( s ) v_{\pi_1} (s) \geq v_{\pi_2} (s) v π 1 ( s ) ≥ v π 2 ( s ) π 1 \pi_1 π 1 π 2 \pi_2 π 2
PPT 形式转化
(Recall that )
转化前公式
(he Bellman equation is )
Bellman equation 括号中是 s i , s j s_i,s_j s i , s j
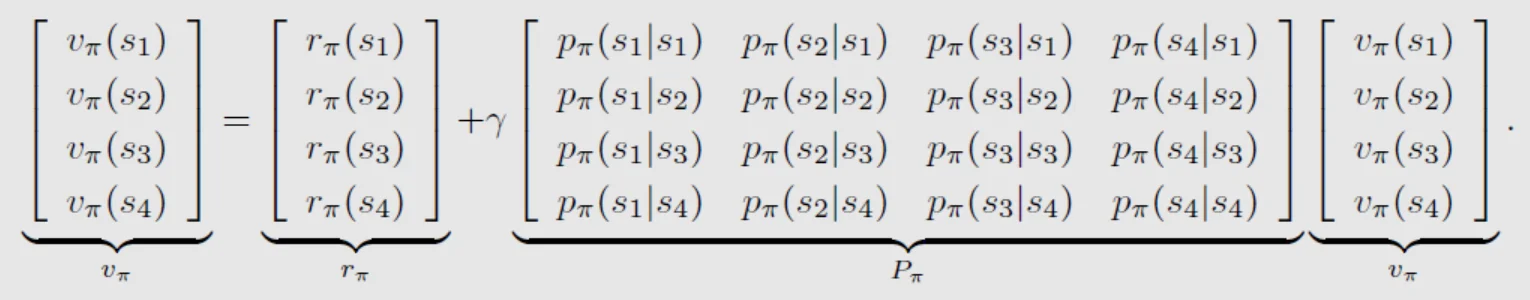
贝尔曼方程也可以转化为矩阵-向量形式:
v π = r π + γ P π v π v_\pi = r_\pi + \gamma P_\pi v_\pi v π = r π + γ P π v π
状态向量: v π = [ v π ( s 1 ) , ⋯ , v π ( s n ) ] T ∈ R n v_\pi = [v_\pi(s_1), \cdots, v_\pi(s_n)]^T \in \mathbb{R}^n v π = [ v π ( s 1 ) , ⋯ , v π ( s n ) ] T ∈ R n
奖励向量: r π = [ r π ( s 1 ) , ⋯ , r π ( s n ) ] T ∈ R n r_\pi = [r_\pi(s_1), \cdots, r_\pi(s_n)]^T \in \mathbb{R}^n r π = [ r π ( s 1 ) , ⋯ , r π ( s n ) ] T ∈ R n
状态转移矩阵: P π ∈ R n × n P_\pi \in \mathbb{R}^{n\times n} P π ∈ R n × n [ P π ] i j = p π ( s j ∣ s i ) [P_\pi]_{ij} = p_\pi (s_j|s_i) [ P π ] ij = p π ( s j ∣ s i ) i i i j j j p π ( s j ∣ s i ) p_\pi (s_j|s_i) p π ( s j ∣ s i )
四个状态时的示例:
(For this specific example )
例子
迭代求解
使用迭代求解的原因:The closed-form solution 和 Matrix-vector form 计算量大
v k + 1 = r π + γ P π v k v_{k+1} = r_\pi + \gamma P_\pi v_k v k + 1 = r π + γ P π v k v k v_k v k v k + 1 v_{k+1} v k + 1 v k + 2 , v k + 3 , ⋯ v_{k+2}, v_{k+3}, \cdots v k + 2 , v k + 3 , ⋯
可以证明,当 k → ∞ k \to \infty k → ∞ v k v_k v k v π v_\pi v π
状态值 vs 动作值
v π ( s ) = ∑ a π ( a ∣ s ) q π ( s , a ) v_\pi (s) = \sum_{a} \pi (a | s) q_\pi (s, a) v π ( s ) = ∑ a π ( a ∣ s ) q π ( s , a )
状态值可以看作是策略 π \pi π
q π ( s , a ) = ∑ s ′ , r p ( s ′ , r ∣ s , a ) [ r + γ v π ( s ′ ) ] q_\pi (s,a) = \sum_{s', r} p(s', r|s, a) [r + \gamma v_{\pi}(s')] q π ( s , a ) = ∑ s ′ , r p ( s ′ , r ∣ s , a ) [ r + γ v π ( s ′ )]
动作值可以通过状态值求解,也可以不依赖于状态值求解。
求解贝尔曼公式,进而得到一个策略所对应的状态值,这样一个过程就被称为策略评价(Policy evaluation)
我评价了一个策略我得到它的值, 然后我基于它的值再改进策略然后这样循环下去, 最后我就能够得到一个最优的策略
🟡贝尔曼最优方程(Bellman Optimality Equation)
RL的目标是最大化累计奖励,则必然存在至少一个最优策略,记作 π ∗ \pi_* π ∗ π \pi π v π ∗ ( s ) ≥ v π ( s ) , ∀ s ∈ S v_{\pi_*} (s) \geq v_{\pi}(s), \forall s\in \mathcal{S} v π ∗ ( s ) ≥ v π ( s ) , ∀ s ∈ S
BOE is tricky yet elegant!
基本形式
最优策略共享相同的最优状态值 v ∗ v_* v ∗ a ∗ a_* a ∗ 寻找最优策略相当于求贝尔曼方程 (v π 、 a π v_\pi、 a_\pi v π 、 a π max π \max_\pi max π
v ∗ ( s ) = max π v π ( s ) = max π ∑ a π ( a ∣ s ) q π ( s , a ) v_∗ (s) = \max_{π} v_π ( s ) = \max_π \sum_{a} π ( a∣s ) q_π ( s , a ) v ∗ ( s ) = max π v π ( s ) = max π ∑ a π ( a ∣ s ) q π ( s , a )
q ∗ ( s , a ) = max π q π ( s , a ) = ∑ s ′ , r p ( s ′ , r ∣ s , a ) [ r + γ v ∗ ( s ′ ) ] q_∗ (s , a) = \max_π q_π (s, a) = \sum_{s',r} p (s',r∣s,a) [r + \gamma v_∗ (s') ] q ∗ ( s , a ) = max π q π ( s , a ) = ∑ s ′ , r p ( s ′ , r ∣ s , a ) [ r + γ v ∗ ( s ′ )]
对应的矩阵-向量形式:
v = max π ( r π + γ P π v ) v = \max_\pi (r_\pi+\gamma P_\pi v) v = max π ( r π + γ P π v )
贝尔曼最优方程是一个特殊的贝尔曼方程,即当策略 π \pi π π ∗ \pi_* π ∗
π ∗ = arg m a x π ( r π + γ P π v ∗ ) \pi_* = \arg max_\pi (r_\pi + \gamma P_\pi v_*) π ∗ = arg ma x π ( r π + γ P π v ∗ )
v ∗ = ( r π ∗ + γ P π ∗ v ∗ ) v_* = (r_{\pi_*}+\gamma P_{\pi_*} v_*) v ∗ = ( r π ∗ + γ P π ∗ v ∗ )
注意:
最优状态值唯一,但最优策略并不唯一
对于一个给定系统,其最优状态值和最优策略受奖励值 r r r γ \gamma γ
最优策略不受奖励值的绝对大小影响,但受其相对大小影响
折扣因子越小(接近0),策略越短视,反之(接近1)策略越长远
迭代求解
考虑贝尔曼最优方程的矩阵-向量形式,设 f ( v ) = max π ( r π + γ P π v ) f(v) = \max_\pi (r_\pi+\gamma P_\pi v) f ( v ) = max π ( r π + γ P π v ) v = f ( v ) v = f ( v ) v = f ( v )
其中 f ( v ) f(v) f ( v ) [ f ( v ) ] s = max π ∑ a π ( a ∣ s ) q ( s , a ) , ∀ s ∈ S [f(v)]_s = \max_\pi \sum_a \pi(a|s)q(s, a), \ \forall s\in\mathcal{S} [ f ( v ) ] s = max π ∑ a π ( a ∣ s ) q ( s , a ) , ∀ s ∈ S
基于压缩映射定理(contraction mapping theorem)可知,v = f ( v ) v = f(v) v = f ( v ) v ∗ v_* v ∗
v k + 1 = max π ( r π + γ P π v k ) v_{k+1} = \max_\pi (r_\pi+\gamma P_\pi v_k) v k + 1 = max π ( r π + γ P π v k ) k = 0 , 1 , 2 , ⋯ k=0, 1,2,\cdots k = 0 , 1 , 2 , ⋯
可以证明,当 k → ∞ k \to \infty k → ∞ v k → v ∗ v_k \to v_* v k → v ∗
通常的求解流程:【实际上就是基于模型(Model-based)中的值迭代(Value Iteration)算法】
对于任意一个状态 s ∈ S s\in\mathcal{S} s ∈ S v k ( s ) v_k(s) v k ( s )
对于任意一个动作 a ∈ A ( s ) a\in\mathcal{A}(s) a ∈ A ( s ) q k ( s , a ) = ∑ s ′ , r p ( s ′ , r ∣ s , a ) [ r + γ v k ( s ′ ) ] q_k(s,a) = \sum_{s',r} p(s', r|s, a) [r + \gamma v_k (s')] q k ( s , a ) = ∑ s ′ , r p ( s ′ , r ∣ s , a ) [ r + γ v k ( s ′ )] v k ( s ′ ) v_k (s') v k ( s ′ )
计算状态 s s s π k + 1 ( a ∣ s ) = { 1 a = a k ∗ ( s ) 0 a ≠ a k ∗ ( s ) \pi_{k+1}(a|s) = \begin{cases} 1 & a=a_k^*(s) \\ 0 & a≠a_k^*(s) \end{cases} π k + 1 ( a ∣ s ) = { 1 0 a = a k ∗ ( s ) a = a k ∗ ( s ) a k ∗ ( s ) = arg m a x a q k ( s , a ) a_k^*(s) = \arg max_a q_k(s, a) a k ∗ ( s ) = arg ma x a q k ( s , a )
计算 v k + 1 ( s ) = max a q k ( s , a ) v_{k+1}(s) = \max_a q_k (s, a) v k + 1 ( s ) = max a q k ( s , a ) v k + 1 ( s ) v_{k+1}(s) v k + 1 ( s ) 0 0 0
在实际应用中,当 ∥ v k + 1 ( s ) − v k ( s ) ∥ \lVert v_{k+1}(s) -v_{k}(s) \rVert ∥ v k + 1 ( s ) − v k ( s )∥
由于精确求解贝尔曼方程往往需要极高的计算开销,所以通常只获得近似解即可。
压缩映射定理(contraction mapping theorem),又称巴拿赫不动点定理(Banach fixed-point theorem)
参考:
非常神奇的数学结论有哪些? - 知乎 Chapter 3: The Contraction Mapping Theorem - UC Davis Math 巴拿赫不动点定理 - 维基百科
直观认识:x x x f ( x ) f(x) f ( x ) f ( x ) f(x) f ( x ) x x x f ( x ) = x f ( x ) = x f ( x ) = x ∥ f ( x 1 ) − f ( x 2 ) ∥ ≤ γ ∣ x 1 − x 2 ∣ \lVert f(x_1)-f(x_2)\rVert \leq \gamma | x_1 - x_2 | ∥ f ( x 1 ) − f ( x 2 )∥ ≤ γ ∣ x 1 − x 2 ∣ γ ∈ ( 0 , 1 ) \gamma\in (0, 1) γ ∈ ( 0 , 1 ) f f f x x x f ( x ) f(x) f ( x ) x x x ∥ ⋅ ∥ \lVert \cdot \rVert ∥ ⋅ ∥ f ( x ) = 0.5 x f(x) = 0.5x f ( x ) = 0.5 x γ = 0.6 \gamma=0.6 γ = 0.6
压缩映射定理是指,若 f f f x ∗ x^* x ∗ f ( x ∗ ) = x f(x^*)=x f ( x ∗ ) = x x ∗ x^∗ x ∗ x k + 1 = f ( x k ) x_{k+1} = f(x_k) x k + 1 = f ( x k ) k → ∞ k \to \infty k → ∞ x ∗ x^* x ∗
例如:以迭代式算法求 f ( x ) = 0.5 x f(x) = 0.5x f ( x ) = 0.5 x x 0 = 10 x_0=10 x 0 = 10 x 1 = 5 , x 2 = 2.5 , x 3 = 1.25 , ⋯ x_1=5, x_2=2.5, x_3=1.25, \cdots x 1 = 5 , x 2 = 2.5 , x 3 = 1.25 , ⋯
γ γ γ γ γ γ
🔺Algorithms Methods
🟡基于模型(Model-Based)
RL算法中存在两种策略:
行为策略(Behavior policy):与环境交互,生成experience采样
目标策略(Target policy):迭代更新,直到收敛至最优策略
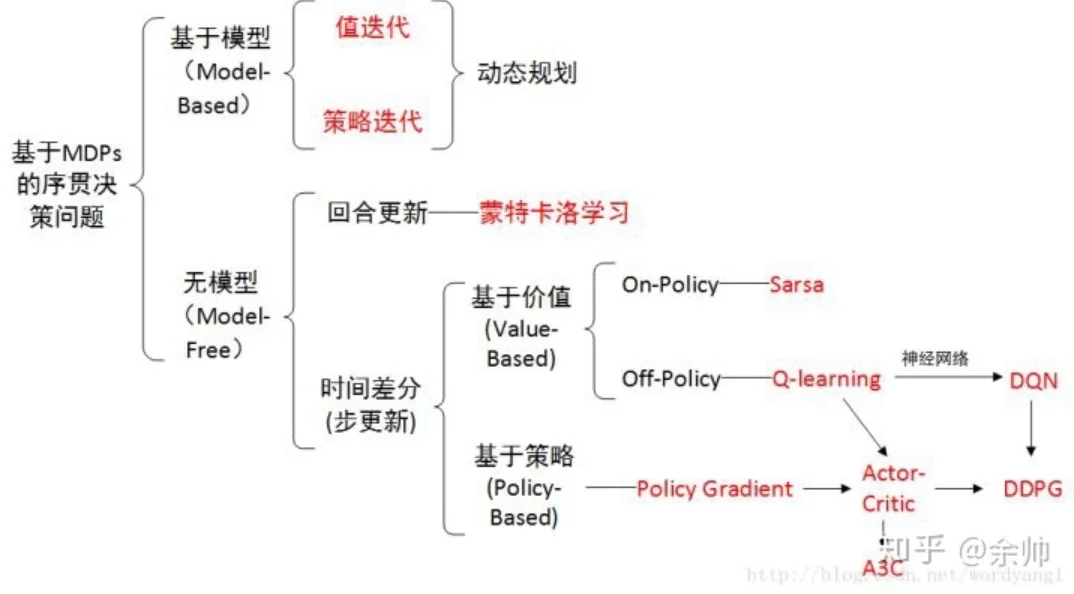
据此,可以将RL算法分为两类:
On-policy :Behavior policy 即为 Target policy,例如 MC、Sarsa 等Off-policy :Behavior policy 与 Target policy 可以不同,例如 Q-learning 等
好处:从别的策略得到的经验中学习,允许更为广泛的探索而不必考虑利用
On-policy可以看作是Off-policy的一种特殊情况,因为Off-policy允许两种策略相同。
基于模型:环境MDP的模型已知,基于动态规划(DP)求解
优:提供了 RL 的理论基础
劣:假设过强(完美的环境模型,比如状态转移矩阵),计算开销过高
基于模型的方法:
策略迭代:收敛速度较快,适用于小状态空间
值迭代:计算量较少,适用于大状态空间
值迭代可以看作是策略迭代的一种特殊情况
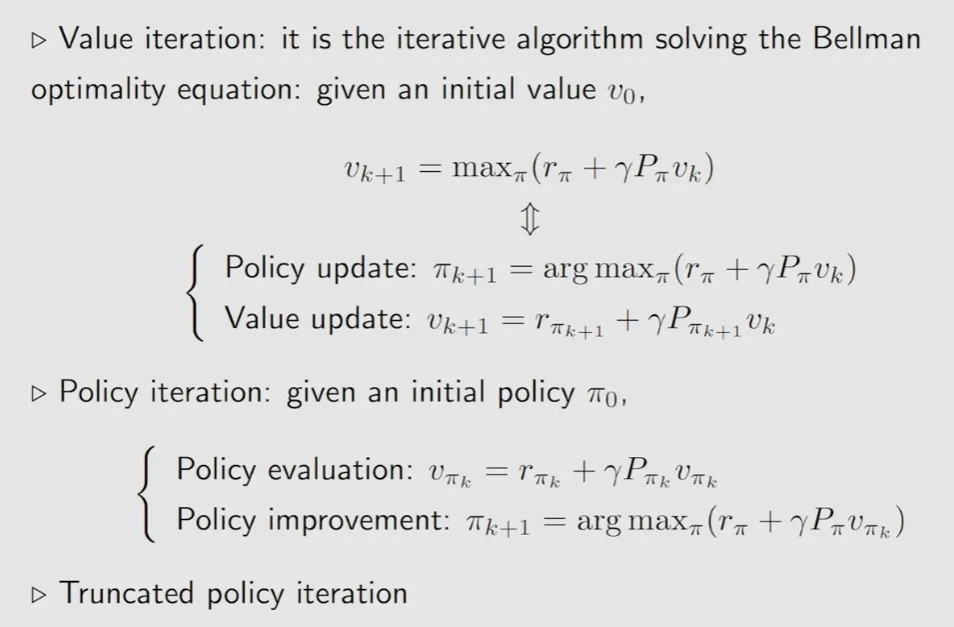
值迭代(Value Iteration)
算法步骤:在第 k k k
策略更新:给定 v k v_k v k π k + 1 = arg m a x π ( r π + γ P π v k ) \pi_{k+1} = \arg max_\pi (r_\pi + \gamma P_\pi v_k) π k + 1 = arg ma x π ( r π + γ P π v k )
值更新:根据策略 π k + 1 \pi_{k+1} π k + 1 v k + 1 = r π k + 1 + γ P π k + 1 + v k v_{k+1} = r_{\pi_{k+1}} + \gamma P_{\pi_{k+1}} + v_k v k + 1 = r π k + 1 + γ P π k + 1 + v k
此处的 v k v_k v k
算法公式:v k + 1 ( s ) = max a ∑ s ′ , r p ( s ′ , r ∣ s , a ) [ r + γ v k ( s ′ ) ] v_{k+1} (s) = \max_a \sum_{s', r} p(s', r|s, a) [r + \gamma v_k(s')] v k + 1 ( s ) = max a ∑ s ′ , r p ( s ′ , r ∣ s , a ) [ r + γ v k ( s ′ )]
伪代码:
复制代码 v[0] = init_state_value()
while ||v_[k] - v_[k-1]|| >= threshold:
for s in StateSpace:
for a in ActionSpace:
q[a] = calculate_q_value(s, a, v_[k])
a_star = get_optimal_action(q)
# policy update
pi[k+1] = update_policy(a_star)
# value update
v[k+1] = update_value(pi[k+1], v_[k])
k = k + 1
值迭代可以看作将贝尔曼优化方程转为一个更新规则 :先计算最优值函数,再从中提取对应的策略作为最优策略
策略迭代(Policy Iteration)
反复执行策略评估(Policy Evaluation,PE)和策略提升(Policy Improvement,PI),直至收敛至最优策略。【能够收敛的要求:有限MDP仅有有限个策略 】
策略评估 :评价某个策略本身如何,即计算任意策略 π \pi π v π v_{\pi} v π v k + 1 ( s ) = ∑ a π ( a ∣ s ) ∑ s ′ , r p ( s ′ , r ∣ s , a ) [ r + γ v k ( s ′ ) ] v_{k+1} (s) = \sum_a \pi (a|s) \sum_{s', r} p(s', r|s, a) [r + \gamma v_k(s')] v k + 1 ( s ) = ∑ a π ( a ∣ s ) ∑ s ′ , r p ( s ′ , r ∣ s , a ) [ r + γ v k ( s ′ )] 注意这里与值迭代的区别:值迭代直接求解最优的状态值,而策略评估仅是计算当前策略的状态值(并不一定是最优)
策略提升 :寻找每个状态下的最好的动作
考虑在状态 s s s π \pi π a = π ′ ( s ) ≠ π ( s ) a = \pi'(s) \neq \pi(s) a = π ′ ( s ) = π ( s ) q π ( s , a ) q_{\pi} (s, a) q π ( s , a ) v π ( s ) v_{\pi} (s) v π ( s ) q π ( s , π ′ ( s ) ) ≥ v π ( s ) q_{\pi}(s, \pi'(s)) \geq v_{\pi} (s) q π ( s , π ′ ( s )) ≥ v π ( s )
新策略 π ′ \pi' π ′ π \pi π v π ′ ( s ) ≥ v π ( s ) v_{\pi'} (s) \geq v_{\pi} (s) v π ′ ( s ) ≥ v π ( s )
那么策略提升就是以贪心的方式选择每个状态下能使动作值函数最大的动作,进而更新策略:
π ′ ( s ) = arg m a x a q π ( s , a ) = arg m a x a ∑ s ′ , r p ( s ′ , r ∣ s , a ) [ r + γ v π ( s ′ ) ] \pi'(s) = \arg max_a q_\pi (s, a) = \arg max_a \sum_{s', r} p(s', r|s, a) [r + \gamma v_\pi(s')] π ′ ( s ) = arg ma x a q π ( s , a ) = arg ma x a ∑ s ′ , r p ( s ′ , r ∣ s , a ) [ r + γ v π ( s ′ )]
算法步骤:在第 k k k π k \pi_k π k π 0 \pi_0 π 0
伪代码:
复制代码 pi[0] = init_policy()
while not pi[k].is_converged:
# policy evaluation
while ||v_[j] - v_[j-1]|| >= threshold:
for s in StateSpace:
v_[j+1][s] = calculate_state_value(pi[k], v_[j][s])
j = j + 1
# policy improvement
for s in StateSpace:
for a in ActionSpace:
q[a] = calculate_q_value(s, a, v[j])
a_star = get_optimal_action(q)
pi[k+1] = update_policy(a_star)
k = k + 1
近水楼台先得月
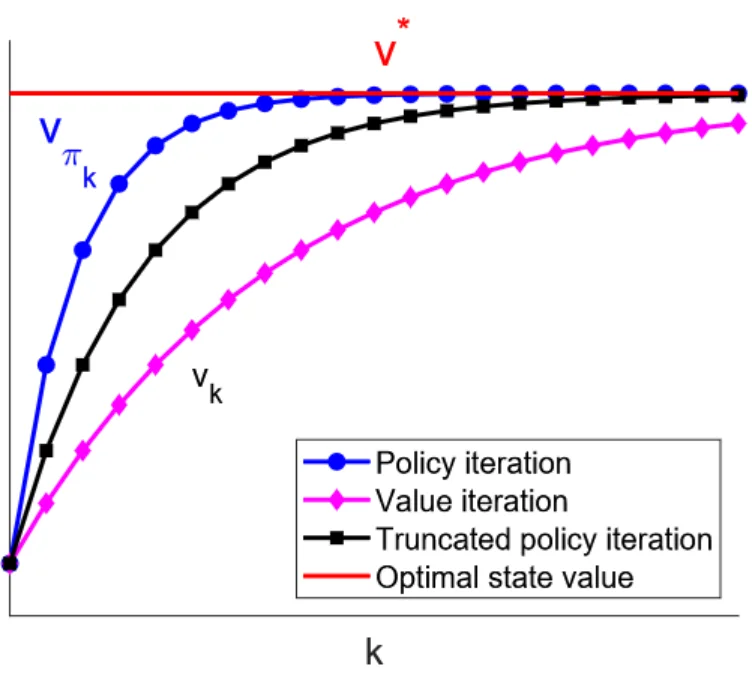
策略迭代中,距离最终目标状态(考虑一个 episode 的最终状态)越近的状态的策略会越早收敛,离目标状态越远的状态的策略会越晚收敛
截断策略迭代(Truncated Policy Iteration)
(Compare value iteration and policy iteration )
比较值迭代和策略迭代
截断策略迭代是值迭代与策略迭代的一般化推广;反过来讲,值迭代与策略迭代都是截断策略迭代的极端情况。
值迭代 vs 策略迭代:
令 v 0 = v π 0 v_0 = v_{\pi_0} v 0 = v π 0
发现:二者的区别在于第四步的 v π 1 ≠ v 1 v_{\pi_1} \neq v_1 v π 1 = v 1
v π 1 v_{\pi_1} v π 1 v 1 v_1 v 1
可以发现,值迭代与策略迭代的根本差异,在于基于贝尔曼最优公式求解状态值的过程
值迭代:仅基于初始状态值,求解一次贝尔曼最优公式
策略迭代:在策略评估部分,每次迭代求解贝尔曼公式(∞次)
实际中,当两次迭代的状态值差异不大的时候,可以认为已经收敛了
而截断策略迭代就是更一般化的情况:迭代 j j j 1 ≤ j < ∞ 1\leq j < \infty 1 ≤ j < ∞
Summary
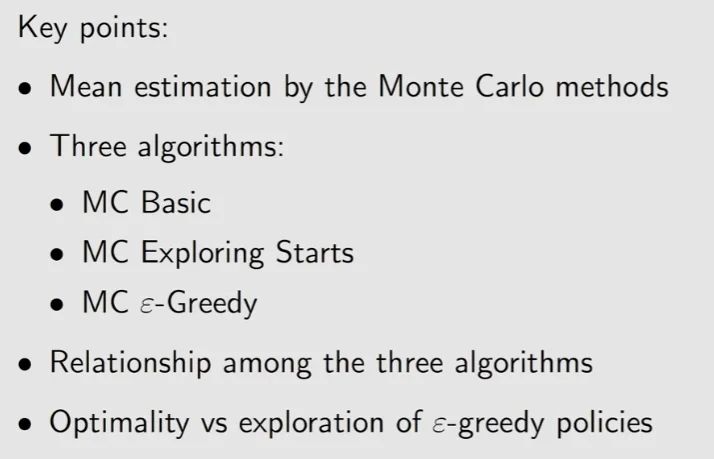
🟡蒙特卡洛方法(Monte Carlo Learning)
求解 RL 问题,要么需要模型,要么需要数据。之前介绍了基于模型(model-based)的方法。然而在实际场景中,环境的模型(如状态转移函数)往往是未知的,这就需要用无模型(model-free)方法解决问题。
无模型的方法可以分为两大类:蒙特卡洛方法(Monte Carlo,MC)和时序差分学习(Temporal Difference,TD)。本文介绍蒙特卡洛方法。
蒙特卡洛思想:通过大数据量的样本采样来进行估计【本质上是大数定律的应用(基于独立同分布采样)】,将策略迭代中依赖于model的部分替换为model-free。
MC的核心idea:并非直接求解 q π ( s , a ) q_{\pi} (s, a) q π ( s , a ) q π ( s , a ) q_{\pi} (s, a) q π ( s , a ) q π ( s , a ) = E π [ G t ∣ S t = s , A t = a ] ≈ 1 N ∑ i = 1 N g ( i ) ( s , a ) q_{\pi}(s, a) = \mathbb{E}_\pi [ G_t | S_t = s, A_t = a ] \approx \frac{1}{N} \sum^N_{i=1} g^{(i)} (s, a) q π ( s , a ) = E π [ G t ∣ S t = s , A t = a ] ≈ N 1 ∑ i = 1 N g ( i ) ( s , a )
其中 g ( i ) ( s , a ) g^{(i)} (s, a) g ( i ) ( s , a ) G t G_t G t i i i
MC Basic
算法步骤:在第 k k k π k \pi_k π k π 0 \pi_0 π 0
策略评估:对每个状态-动作对 ( s , a ) (s, a) ( s , a ) q π k ( s , a ) q_{\pi_{k}} (s, a) q π k ( s , a )
策略提升:基于估算的 q π k ( s , a ) q_{\pi_{k}} (s, a) q π k ( s , a ) π k + 1 ( s ) = arg m a x π ∑ a π ( a ∣ s ) q π k ( s , a ) \pi_{k+1}(s) = \arg max_\pi \sum_a \pi(a|s) q_{\pi_{k}}(s, a) π k + 1 ( s ) = arg ma x π ∑ a π ( a ∣ s ) q π k ( s , a )
MC Basic与策略迭代的区别:在第 k k k
策略迭代使用迭代方法求出状态值 v π k v_{\pi_k} v π k q π k ( s , a ) q_{\pi_k} (s, a) q π k ( s , a )
MC Basic直接基于采样/经验均值估计 q π k ( s , a ) q_{\pi_k} (s, a) q π k ( s , a )
MC Basic 只是用来说明 MC 的核心 idea,并不会在实际中应用,因为其非常低效。
MC Exploring Starts
思想:提升MC Basic的效率
利用数据:对于一个轨迹,从后往前利用 ( s , a ) (s, a) ( s , a )
例如:对于轨迹 s 1 → a 2 s 2 → a 4 s 1 → a 2 s 2 → a 3 s 5 → a 1 ⋯ s_1 \xrightarrow{a_2} s_2 \xrightarrow{a_4} s_1 \xrightarrow{a_2} s_2 \xrightarrow{a_3} s_5 \xrightarrow{a_1} \cdots s 1 a 2 s 2 a 4 s 1 a 2 s 2 a 3 s 5 a 1 ⋯ q π ( s 5 , a 1 ) q_\pi(s_5, a_1) q π ( s 5 , a 1 ) q π ( s 2 , a 3 ) = R t + 4 + γ q π ( s 5 , a 1 ) q_\pi(s_2, a_3) = R_{t+4} + \gamma q_\pi(s_5, a_1) q π ( s 2 , a 3 ) = R t + 4 + γ q π ( s 5 , a 1 ) q π ( s 1 , a 2 ) = R t + 3 + γ q π ( s 2 , a 3 ) q_\pi(s_1, a_2) = R_{t+3} + \gamma q_\pi(s_2, a_3) q π ( s 1 , a 2 ) = R t + 3 + γ q π ( s 2 , a 3 )
更新策略:不必等待所有 episode 的数据收集完毕,直接基于单个 episode 进行估计,类似于截断策略迭代(单次估计不准确,但快)
这是通用策略迭代(Generalized Policy Iteration,GPI)的思想
MC Exploring Starts
Exploring:探索每个 ( s , a ) (s, a) ( s , a )
Starts:从每个状态-动作对开始一个 episode
与 Visit 对应:从其他的状态-动作对开始一个 episode,但其轨迹能经过当前的状态-动作对
MC ε-Greedy
Exploring Starts 在实际中难以实现(实际和理论存在一个gap),考虑引入 soft policy:随机(stochastic)选择动作
ε-Greedy策略 :
π ( a ∣ s ) = { 1 − ε ∣ A ( s ) ∣ ( ∣ A ( s ) ∣ − 1 ) , f o r t h e g r e e d y a c t i o n , ε ∣ A ( s ) ∣ , f o r o t h e r ∣ A ( s ) ∣ − 1 a c t i o n s . } \pi(a|s) = \begin{Bmatrix} 1− \frac{\varepsilon}{|A(s)|}(|A(s)|−1), & for \ the \ greedy \ action, \\ \frac{\varepsilon}{|A(s)|}, & for \ other \ |A(s)|−1 \ actions. \end{Bmatrix} π ( a ∣ s ) = { 1 − ∣ A ( s ) ∣ ε ( ∣ A ( s ) ∣ − 1 ) , ∣ A ( s ) ∣ ε , f or t h e g r ee d y a c t i o n , f or o t h er ∣ A ( s ) ∣ − 1 a c t i o n s . }
其中, ε ∈ [ 0 , 1 ] \varepsilon \in [0,1] ε ∈ [ 0 , 1 ] ∣ A ( s ) ∣ |\mathcal{A}(s)| ∣ A ( s ) ∣ s s s
直观理解:以较高概率选择贪心动作(greedy action),以较低均等概率选择其他动作
特性:选择贪心动作的概率永远不低于选择其他动作的概率
目的:平衡exploitation(探索)和 exploration(利用)
ε = 0 \varepsilon = 0 ε = 0 ε = 1 \varepsilon = 1 ε = 1
MC ε-Greedy :在策略提升阶段,求解下式
π k + 1 ( s ) = arg m a x π ∈ Π ε ∑ a π ( a ∣ s ) q π k ( s , a ) \pi_{k+1}(s) = \arg max_{\color{red}\pi \in \Pi_\varepsilon} \sum_a \pi(a|s) q_{\pi_{k}}(s, a) π k + 1 ( s ) = arg ma x π ∈ Π ε ∑ a π ( a ∣ s ) q π k ( s , a ) π ∈ Π ε \pi \in \Pi_\varepsilon π ∈ Π ε
π ( a ∣ s ) = { 1 − ε ∣ A ( s ) ∣ ( ∣ A ( s ) ∣ − 1 ) , a = a k ∗ , ε ∣ A ( s ) ∣ , a ≠ a k ∗ . } \pi(a|s) = \begin{Bmatrix} 1− \frac{\varepsilon}{|A(s)|}(|A(s)|−1), & a = a_k^*, \\ \frac{\varepsilon}{|A(s)|}, & a ≠ a_k^*. \end{Bmatrix} π ( a ∣ s ) = { 1 − ∣ A ( s ) ∣ ε ( ∣ A ( s ) ∣ − 1 ) , ∣ A ( s ) ∣ ε , a = a k ∗ , a = a k ∗ . }
MC ε-Greedy 与 MC Basic 和 MC Exploring Starts 的区别:
后二者求解的范围是 π ∈ Π \pi \in \Pi π ∈ Π
后二者得到的是确定性策略,前者得到的是随机策略
MC ε-Greedy 与 MC Exploring Starts 的唯一区别在于 ε-Greedy 策略,因此 MC ε-Greedy 不需要 Exploring Starts。
MC ε-Greedy 通过探索性牺牲了最优性,但可以通过设置一个较小的 ε(如0.1)进行平衡
在实际中,可以为 ε 设置一个较大的初始值,随着迭代轮数逐渐减小其取值
ε 的值越大 ,最终策略的最优性越差
最终训练得到的策略,可以去掉 ε,直接使用 greedy 的确定性策略(consistent)。
🟡随机近似(SA)&随机梯度下降(SGD)
考虑求解均值估计(Mean Estimation)问题,MC 利用采样的算数均值来估计期望,但缺点是需要等待所有样本收集完毕后再进行计算。
举例:如何增量和迭代式地计算均值?w k + 1 = 1 k ∑ i = 1 k x i w_{k+1} = \frac{1}{k} \sum_{i=1}^{k} x_i w k + 1 = k 1 ∑ i = 1 k x i
w k + 1 = w k − 1 k ( w k − x k ) w_{k+1} = w_k - \frac{1}{k} (w_k - x_k) w k + 1 = w k − k 1 ( w k − x k )
基于该方式,只需要基于过去的均值计算结果 w k w_k w k x k x_k x k
可以对上式进一步推广,得到
w k + 1 = w k − α k ( w k − x k ) w_{k+1} = w_k - {\color{red}\alpha_k} (w_k - x_k) w k + 1 = w k − α k ( w k − x k )
其中 α k > 0 \alpha_k>0 α k > 0 α k \alpha_k α k
随机近似(Stochastic Approximation,SA):一类随机迭代算法,适用于方程求解或优化问题,但不需要目标函数/方程的表达式/导数形式。
Robbins-Monro(RM)算法
目标:在不知道 g ( w ) g(w) g ( w ) g ( w ) = 0 g(w) = 0 g ( w ) = 0 w ∗ w^* w ∗
RM算法:w k + 1 = w k − a k g ~ ( w k , η k ) w_{k+1} = w_k - a_k \tilde{g} (w_k, \eta_k) w k + 1 = w k − a k g ~ ( w k , η k )
(the problem becomes a root-finding problem: g(w) = 0. The corresponding RM algorithm is )
The problem becomes a root-finding problem: g(w) = 0. The corresponding RM algorithm is
w k + 1 = w k − a k g ~ ( w k , η k ) = w k − a k ( w k − x k ) w_{k+1} = w_k - a_k \tilde{g} (w_k, \eta_k) = w_k - a_k (w_k - x_k) w k + 1 = w k − a k g ~ ( w k , η k ) = w k − a k ( w k − x k )
w k w_k w k w ∗ w^* w ∗ k k k g ~ ( w k , η k ) = g ( w k ) + η k \tilde{g} (w_k, \eta_k) = g(w_k) + \eta_k g ~ ( w k , η k ) = g ( w k ) + η k η k \eta_k η k g ~ \tilde{g} g ~ g g g a k > 0 a_k>0 a k > 0
RM算法依赖于数据:
输入序列: w k {w_k} w k
带噪声的输出序列: { g ~ ( w k , η k ) } \{ \tilde{g} (w_k, \eta_k) \} { g ~ ( w k , η k )}
RM定理(收敛性) :在RM算法中,当以下三个条件成立时, w k w_k w k w ∗ w^* w ∗
g ( w ) g(w) g ( w ) 0 < c 1 ≤ ∇ w g ( w ) ≤ c 2 , ∀ w 0 < c_1 \leq \nabla_{w} g(w) \leq c_2, \ \forall w 0 < c 1 ≤ ∇ w g ( w ) ≤ c 2 , ∀ w
g g g g ( w ) = 0 g(w)=0 g ( w ) = 0 g g g
a k a_k a k ∑ k = 1 ∞ a k = ∞ \textstyle\sum_{k=1}^{\infty} a_k = \infty ∑ k = 1 ∞ a k = ∞ ∑ k = 1 ∞ a k 2 < ∞ \textstyle\sum_{k=1}^{\infty} a_k^2 < \infty ∑ k = 1 ∞ a k 2 < ∞
平方和小于无穷:随着 k → ∞ k \to \infty k → ∞ a k a_k a k
和等于无穷: a k a_k a k
η k \eta_k η k E [ η k ∣ H k ] = 0 \mathbb{E} [\eta_k | \mathcal{H}_k] = 0 E [ η k ∣ H k ] = 0 E [ η k 2 ∣ H k ] < ∞ \mathbb{E} [\eta_k^2 | \mathcal{H}_k] < \infty E [ η k 2 ∣ H k ] < ∞
η k \eta_k η k 0 0 0 常见情形:η k {\eta_k} η k
a k a_k a k a k = 1 k a_k = \frac{1}{k} a k = k 1
∑ k = 1 ∞ a k = ∞ \sum_{k=1}^{\infty} a_k = \infty ∑ k = 1 ∞ a k = ∞
欧拉常数(Euler-Mascheroni constant)γ = lim n → ∞ ( ∑ k = 1 n 1 k − ln n ) ≈ 0.557 \gamma = \lim_{n \to \infty} (\sum_{k=1}^{n}\frac{1}{k} - \ln n) \approx 0.557 γ = lim n → ∞ ( ∑ k = 1 n k 1 − ln n ) ≈ 0.557 n → ∞ n \to \infty n → ∞ ln n → ∞ \ln n \to \infty ln n → ∞ ∑ k = 1 ∞ 1 k = ∞ \sum_{k=1}^{\infty}\frac{1}{k} = \infty ∑ k = 1 ∞ k 1 = ∞
∑ k = 1 ∞ a k 2 < ∞ \textstyle \sum_{k=1}^{\infty} a_k^2 < \infty ∑ k = 1 ∞ a k 2 < ∞
巴塞尔问题(Basel Problem)∑ k = 1 ∞ 1 k 2 = π 2 6 < ∞ \sum_{k=1}^{\infty}\frac{1}{k^2} = \frac{\pi^2}{6} < \infty ∑ k = 1 ∞ k 2 1 = 6 π 2 < ∞
随机梯度下降(Stochastic Gradient Descent,SGD)
SGD是RM算法的一种特殊情况。
目标:求解以下优化问题
min w J ( w ) = E [ f ( w , X ) ] \min_w \ J(w) = \mathbb{E} [f(w, X)] min w J ( w ) = E [ f ( w , X )]
w w w X X X E \mathbb{E} E X X X w w w X X X f ( ⋅ ) f(\cdot) f ( ⋅ )
最小化用梯度下降,最大化用梯度上升
求解方法1:GD(Gradient Descent)
w k + 1 = w k − α k ∇ w E [ f ( w k , X ) ] = w k − α k E [ ∇ w f ( w k , X ) ] w_{k+1} = w_k - \alpha_k \nabla_w \mathbb{E}[f(w_k, X)] = w_k - \alpha_k \mathbb{E}[\nabla_w f(w_k, X)] w k + 1 = w k − α k ∇ w E [ f ( w k , X )] = w k − α k E [ ∇ w f ( w k , X )]
求解方法2:BGD(Batch Gradient Descent),基于数据采样计算期望
E [ ∇ w f ( w k , X ) ] ≈ 1 n ∑ i = 1 n ∇ w f ( w k , x i ) \mathbb{E}[\nabla_w f(w_k, X)] \approx \frac{1}{n} \sum_{i=1}^{n} \nabla_w f(w_k, x_i) E [ ∇ w f ( w k , X )] ≈ n 1 ∑ i = 1 n ∇ w f ( w k , x i ) n n n w k + 1 = w k − α k 1 n ∑ i = 1 n ∇ w f ( w k , x i ) w_{k+1} = w_k - \alpha_k \frac{1}{n} \sum_{i=1}^{n} \nabla_w f(w_k, x_i) w k + 1 = w k − α k n 1 ∑ i = 1 n ∇ w f ( w k , x i )
缺陷: w k w_k w k
求解方法3:随机梯度下降(Stochastic Gradient Descent)SGD
w k + 1 = w k − α k ∇ w f ( w k , x k ) w_{k+1} = w_k - \alpha_k \nabla_w f(w_k, x_k) w k + 1 = w k − α k ∇ w f ( w k , x k )
与GD的差异:将真实梯度(true gradient) E [ ∇ w f ( w k , X ) ] \mathbb{E}[\nabla_w f(w_k, X)] E [ ∇ w f ( w k , X )] ∇ w f ( w k , x k ) \nabla_w f(w_k, x_k) ∇ w f ( w k , x k )
与BGD的差异:仅采样一次(n = 1 n=1 n = 1
SGD收敛性 :若以下三个条件成立,则 w k w_k w k w ∗ w^* w ∗ ∇ w E [ f ( w , X ) ] = 0 \nabla_w \mathbb{E} [f(w, X)] = 0 ∇ w E [ f ( w , X )] = 0
0 < c 1 ≤ ∇ w 2 f ( w , X ) ≤ c 2 0 < c_1 \leq \nabla_{w}^2 f(w, X) \leq c_2 0 < c 1 ≤ ∇ w 2 f ( w , X ) ≤ c 2 f ( ⋅ ) f(\cdot) f ( ⋅ ) ∑ k = 1 ∞ a k = ∞ \textstyle\sum_{k=1}^{\infty} a_k = \infty ∑ k = 1 ∞ a k = ∞ ∑ k = 1 ∞ a k 2 < ∞ \textstyle\sum_{k=1}^{\infty} a_k^2 < \infty ∑ k = 1 ∞ a k 2 < ∞ x k k = 1 ∞ {x_k}_{k=1}^{\infty} x k k = 1 ∞
SGD的收敛模式:
当 w k w_k w k w ∗ w^* w ∗ w k w_k w k w ∗ w^* w ∗
当 w k w_k w k w ∗ w^* w ∗ w k w_k w k w ∗ w^* w ∗
BGD / MBGD / SGD
MBGD可以视作BGD和SGD的一种中间情况
m = 1 m=1 m = 1 m = n m=n m = n
BGD 对每个采样使用 1 次,MBGD 是从 n n n n n n
🟡时序差分学习(Temporal Difference,TD)
先前的内容介绍了如何在无模型(model-free)的情况下,基于蒙特卡洛方法(Monte Carlo,MC)来进行策略评估。实际上,无模型的强化学习方法还有另外一个重要分支:时序差分学习(Temporal Difference,TD)。
最基础的时序差分学习估计状态值,而后续提出的Sarsa和Q-learning方法则直接对动作值进行估计。
注:时序差分的原理部分依赖于随机优化理论,可参阅本文后续的随机近似(SA)&随机梯度下降(SGD)章节。
TD for state values
Basic TD
最原始的 TD Learning 算法:在策略评估中估计给定策略 π \pi π v π v_\pi v π
v t + 1 ( s t ) = v t ( s t ) − α ( s t ) [ v t ( s t ) − [ r t + 1 + γ v t ( s t + 1 ) ] ] v_{t+1}(s_t) = v_t(s_t) - \alpha(s_t) [v_t (s_t) - [r_{t+1} + \gamma v_t(s_{t+1})] ] v t + 1 ( s t ) = v t ( s t ) − α ( s t ) [ v t ( s t ) − [ r t + 1 + γ v t ( s t + 1 )]]
α t ( s t ) \alpha_t (s_t) α t ( s t )
v t + 1 ( s ) = v t ( s ) , ∀ s ≠ s t v_{t+1} (s) = v_t (s), \quad \forall s \neq s_t v t + 1 ( s ) = v t ( s ) , ∀ s = s t
在 t = 0 , 1 , 2 , ⋯ t =0, 1,2, \cdots t = 0 , 1 , 2 , ⋯ s t s_t s t v t + 1 ( s t ) v_{t+1}(s_t) v t + 1 ( s t )
TD的目标 :使得估计值 v t ( s t ) v_{t}(s_t) v t ( s t ) v ˉ t \bar{v}_t v ˉ t q t ( s t , a t ) q_t(s_t, a_t) q t ( s t , a t ) q ˉ t \bar{q}_t q ˉ t v t + 1 ( s t ) ⏟ new estimation = v t ( s t ) ⏟ current estimation − α ( s t ) [ v t ( s t ) − r t + 1 + γ v t ( s t + 1 ) ⏟ TD target v ˉ t ⏞ TD target δ t ] \underbrace{v_{t+1}(s_t)}_{\text{new estimation}} = \underbrace{v_t(s_t)}_{\text{current estimation}} - \alpha(s_t) [\overbrace{v_t (s_t) -\underbrace{r_{t+1} + \gamma v_t(s_{t+1})}_{\text{TD target} \ \bar{v}_t}}^{\text{TD target} \ \delta_{t}}] new estimation v t + 1 ( s t ) = current estimation v t ( s t ) − α ( s t ) [ v t ( s t ) − TD target v ˉ t r t + 1 + γ v t ( s t + 1 ) TD target δ t ]
TD target : v ˉ t = r t + 1 + γ v t ( s t + 1 ) \bar{v}_t = r_{t+1} + \gamma v_t(s_{t+1}) v ˉ t = r t + 1 + γ v t ( s t + 1 ) TD error : δ t = v t ( s t ) − [ r t + 1 + γ v t ( s t + 1 ) ] = v t ( s t ) − v ˉ t \delta_t = v_t (s_t) - [r_{t+1} + \gamma v_t(s_{t+1})] = v_{t}(s_t) - \bar{v}_t δ t = v t ( s t ) − [ r t + 1 + γ v t ( s t + 1 )] = v t ( s t ) − v ˉ t
是 t t t t + 1 t+1 t + 1
描述了 v t v_t v t v π v_\pi v π v t v_t v t v π v_\pi v π v t = v π v_t = v_\pi v t = v π δ t = 0 \delta_t = 0 δ t = 0
这种最原始的 TD 算法不能用来估计动作值,也不能用来搜索最优策略。
注:不同文献和资料中的公式表述存在差异,比如Sutton书中(参考资料2)的TD形式如下:V ( S t ) ← V ( S t ) + α [ R t + 1 + γ V ( S t + 1 ) − V ( S t ) ] V(S_t) \gets V(S_t) + \alpha [R_{t+1} + \gamma V(S_{t+1}) - V(S_t)] V ( S t ) ← V ( S t ) + α [ R t + 1 + γ V ( S t + 1 ) − V ( S t )]
TD算法本质上是求解贝尔曼期望方程(Bellman Expectation Equation):v π ( s ) = E [ R + γ v π ( S ′ ) ∣ S = s ] , s ∈ S v_\pi(s) = \mathbb{E} [R + \gamma v_\pi (S') | S = s], \quad s \in S v π ( s ) = E [ R + γ v π ( S ′ ) ∣ S = s ] , s ∈ S
TD 算法的收敛性:如满足以下条件,则当 t → ∞ t \to \infty t → ∞ v t ( s ) v_t(s) v t ( s ) v π ( s ) v_\pi(s) v π ( s ) ∀ s ∈ S \forall s \in \mathcal{S} ∀ s ∈ S ∑ t a t ( s ) = ∞ \textstyle\sum_{t} a_t(s) = \infty ∑ t a t ( s ) = ∞ ∑ t a t 2 ( s ) < ∞ \textstyle\sum_{t} a_t^2(s) < \infty ∑ t a t 2 ( s ) < ∞
TD vs MC
TD估计的期望是有偏的,因为其依赖于初始估计(Bootstrapping),但随着数据量的增加,最终会收敛到正确的估计值;相反,MC的期望是无偏估计。
Sarsa (TD for action values)
Basic Sarsa
目标:估计给定策略 π \pi π q π ( s , a ) q_\pi(s, a) q π ( s , a ) { s t , a t , r t + 1 , s t + 1 , a t + 1 } \{ s_t, a_t, r_{t+1}, s_{t+1}, a_{t+1} \} { s t , a t , r t + 1 , s t + 1 , a t + 1 }
SARSA(State-Action-Reward-State-Action) 算法:
q t + 1 ( s t , a t ) = q t ( s t , a t ) − α t ( s t , a t ) [ q t ( s t , a t ) − [ r t + 1 + γ q t ( s t + 1 , a t + 1 ) ] ] q_{t+1} (s_{t}, a_t) = q_{t} (s_{t}, a_t) - \alpha_t (s_t, a_t) [q_{t} (s_t, a_t) - [r_{t+1} + \gamma {\color{red} q_t (s_{t+1}, a_{t+1})}]] q t + 1 ( s t , a t ) = q t ( s t , a t ) − α t ( s t , a t ) [ q t ( s t , a t ) − [ r t + 1 + γ q t ( s t + 1 , a t + 1 ) ]]
q t + 1 ( s , a ) = q t ( s , a ) , ∀ ( s , a ) ≠ ( s t , a t ) q_{t+1} (s, a) = q_t (s, a), \quad \forall (s, a) \neq (s_t, a_t) q t + 1 ( s , a ) = q t ( s , a ) , ∀ ( s , a ) = ( s t , a t )
α t ( s t , a t ) \alpha_t (s_t, a_t) α t ( s t , a t ) s t s_t s t a t a_t a t
与原始 TD 算法的差异:将公式中的 v ( s t ) v(s_t) v ( s t ) q ( s t , a t ) q(s_t, a_t) q ( s t , a t )
Sarsa求解贝尔曼期望方程的动作值形式:q π ( s , a ) = E [ R + γ q π ( S ′ , A ′ ) ∣ s , a ] , ∀ s , a q_\pi(s, a) = \mathbb{E} [R + \gamma q_\pi (S', A') | s, a], \quad \forall s, a q π ( s , a ) = E [ R + γ q π ( S ′ , A ′ ) ∣ s , a ] , ∀ s , a
其中, R ∼ p ( R ∣ s , a ) R \sim p (R | s ,a) R ∼ p ( R ∣ s , a ) S ′ ∼ p ( S ′ ∣ s , a ) S' \sim p(S' | s, a) S ′ ∼ p ( S ′ ∣ s , a ) A ′ ∼ π ( A ′ ∣ S ′ ) A' \sim \pi(A' | S') A ′ ∼ π ( A ′ ∣ S ′ ) ∼ \sim ∼
注意到 Sarsa 所依赖的 5 个变量中,在给定 s t s_t s t a t a_t a t a t + 1 a_{t+1} a t + 1 π t \pi_t π t r t + 1 r_{t+1} r t + 1 s t + 1 s_{t+1} s t + 1
Sarsa 收敛性类似于 TD,略。
Sarsa+ 策略提升的完整算法:(也属于GPI框架)
更新动作值(策略评估):Sarsa 的公式,略
更新策略(策略提升):ε-Greedy 方法,基于 q t + 1 ( s t , a ) q_{t+1} (s_t, a) q t + 1 ( s t , a )
π k + 1 ( a ∣ s t ) = { 1 − ε ∣ A ( s ) ∣ ( ∣ A ( s ) ∣ − 1 ) , i f a = a r g m a x a q t + 1 ( s t , a ) ε ∣ A ( s ) ∣ , o t h e r w i s e \pi_{k+1}(a|s_t) = \begin{cases} 1− \frac{\varepsilon}{|A(s)|}(|A(s)|−1), & if \ a = arg max_{a} \ q_{t+1}(s_t,a) \\ \frac{\varepsilon}{|A(s)|}, & otherwise \end{cases} π k + 1 ( a ∣ s t ) = { 1 − ∣ A ( s ) ∣ ε ( ∣ A ( s ) ∣ − 1 ) , ∣ A ( s ) ∣ ε , i f a = a r g ma x a q t + 1 ( s t , a ) o t h er w i se
Sarsa有两个变体:Expected Sarsa 和 n-step Sarsa
变体1:Expected Sarsa
q t + 1 ( s t , a t ) = q t ( s t , a t ) − α t ( s t , a t ) [ q t ( s t , a t ) − [ r t + 1 + γ E q t ( s t + 1 , A ) ] ] q_{t+1} (s_{t}, a_t) = q_{t} (s_{t}, a_t) - \alpha_t (s_t, a_t) [q_{t} (s_t, a_t) - [r_{t+1} + \gamma {\color{red} \mathbb{E} q_t (s_{t+1}, A)}]] q t + 1 ( s t , a t ) = q t ( s t , a t ) − α t ( s t , a t ) [ q t ( s t , a t ) − [ r t + 1 + γ E q t ( s t + 1 , A ) ]]
q t + 1 ( s , a ) = q t ( s , a ) , ∀ ( s , a ) ≠ ( s t , a t ) q_{t+1} (s, a) = q_t (s, a), \quad \forall (s, a) \neq (s_t, a_t) q t + 1 ( s , a ) = q t ( s , a ) , ∀ ( s , a ) = ( s t , a t )
其中, E q t ( s t + 1 , A ) = v t ( s t + 1 ) \mathbb{E} q_t (s_{t+1}, A) = v_t (s_{t + 1}) E q t ( s t + 1 , A ) = v t ( s t + 1 )
Expected Sarsa求解以下形式的贝尔曼公式:q π ( s , a ) = E [ R t + 1 + γ v π ( S t + 1 ) ∣ S t = s , A t = a ] q_\pi (s, a) = \mathbb{E} [R_{t+1} + \gamma v_\pi(S_{t+1}) | S_t =s, A_t =a] q π ( s , a ) = E [ R t + 1 + γ v π ( S t + 1 ) ∣ S t = s , A t = a ]
与Sarsa的区别:
改变了TD Target
需要更多的计算量,但减少了随机变量个数(不需要对 a t + 1 a_{t+1} a t + 1
变体2:n-step Sarsa
n-step Sarsa是Sarsa的推广,统一了Sarsa和MC的思想
Sarsa基于单步采样进行估计,MC基于∞步采样进行估计,因此n-step Sarsa相当于是二者的折中
n-step Sarsa既不是online的,也不是offline的(或者是是特殊的online方法)
公式及其他细节略。
Q-learing (TD for optimal action values)
Q-learing直接估计最优动作值,因此不需要策略评估-策略提升的过程。
q t + 1 ( s t , a t ) = q t ( s t , a t ) − α t ( s t , a t ) [ q t ( s t , a t ) − [ r t + 1 + γ max a ∈ A q t ( s t + 1 , a ) ] ] q_{t+1} (s_{t}, a_t) = q_{t} (s_{t}, a_t) - \alpha_t (s_t, a_t) [q_{t} (s_t, a_t) - [r_{t+1} + \gamma {\color{red} \max_{a \in \mathcal{A}} q_t (s_{t+1}, a)}]] q t + 1 ( s t , a t ) = q t ( s t , a t ) − α t ( s t , a t ) [ q t ( s t , a t ) − [ r t + 1 + γ m a x a ∈ A q t ( s t + 1 , a ) ]] q t + 1 ( s , a ) = q t ( s , a ) , ∀ ( s , a ) ≠ ( s t , a t ) q_{t+1} (s, a) = q_t (s, a), \quad \forall (s, a) \neq (s_t, a_t) q t + 1 ( s , a ) = q t ( s , a ) , ∀ ( s , a ) = ( s t , a t )
Q-learing和Sarsa在公式上的唯一区别是TD target(公式的红字部分)。每个状态下,Q-learing在对action进行优化,但Sarsa只是依据当前策略选择action。
Sarsa求解贝尔曼方程,但Q-learing求解贝尔曼最优方程:q ( s , a ) = E [ R t + 1 + γ max a q ( s t + 1 , a ) ∣ S t = s , A t = a ] , ∀ s , a q(s, a) = \mathbb{E} [ R_{t+1} + \gamma \max_a q(s_{t+1}, a) | S_t =s, A_t = a ], \ \forall s,a q ( s , a ) = E [ R t + 1 + γ max a q ( s t + 1 , a ) ∣ S t = s , A t = a ] , ∀ s , a
此外,Sarsa属于on-policy算法,而Q-learing属于off-policy算法。
Sarsa所需的 a t + 1 a_{t+1} a t + 1 π t \pi_t π t π t + 1 \pi_{t+1} π t + 1
Q-learing所需的数据为 ( s t , a t , r t + 1 , s t + 1 ) {(s_t, a_t, r_{t+1}, s_{t+1})} ( s t , a t , r t + 1 , s t + 1 )
二者相同时,Q-learing即为on-policy
Q-learing算法步骤(off-policy):π B \pi_B π B { s 0 , a 0 , r 1 , s 1 , a 1 , r 2 , ⋯ } \{ s_0, a_0, r_1, s_1, a_1, r_2, \cdots \} { s 0 , a 0 , r 1 , s 1 , a 1 , r 2 , ⋯ }
例子: π B \pi_B π B ε = 1 \varepsilon =1 ε = 1
在每个 episode 的每个时间步 t = 0 , 1 , 2 , ⋯ t=0,1,2,\cdots t = 0 , 1 , 2 , ⋯
更新最优动作值(q-value)的估计:Q-learing的公式,略
更新目标策略 π T \pi_T π T π T , t + 1 = { 1 i f a = a r g m a x a q t + 1 ( s t , a ) 0 o t h e r w i s e \pi_{T, t+1} = \begin{cases} 1 & if \ a = arg max_{a} \ q_{t+1}(s_t,a) \\ 0 & otherwise \end{cases} π T , t + 1 = { 1 0 i f a = a r g ma x a q t + 1 ( s t , a ) o t h er w i se
是 greedy,但不是 ε-greedy(不需要探索)
对于 off-policy 的 Q-learing 而言,行为策略的探索性越强,其目标策略收敛于最优策略的速度越快。
TD算法汇总
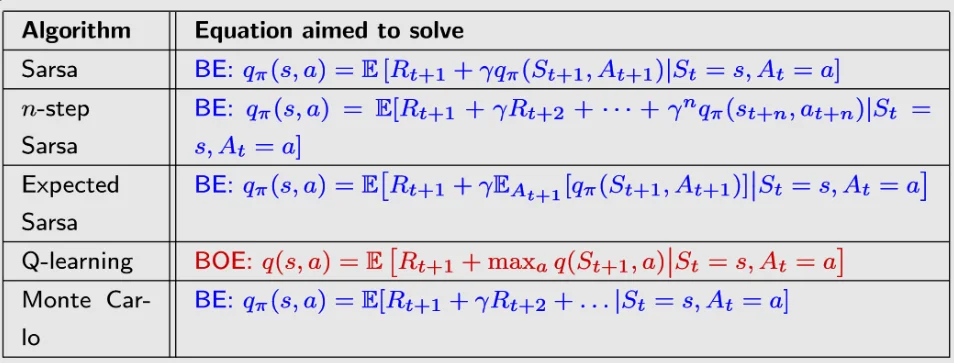
所有估计动作值的TD算法可以由下式统一表示:q t + 1 ( s t , a t ) = q t ( s t , a t ) − α t ( s t , a t ) [ q t ( s t , a t ) − q ˉ t ] q_{t+1} (s_{t}, a_t) = q_{t} (s_{t}, a_t) - \alpha_t (s_t, a_t) [q_{t} (s_t, a_t) - {\color{blue} \bar{q}_t}] q t + 1 ( s t , a t ) = q t ( s t , a t ) − α t ( s t , a t ) [ q t ( s t , a t ) − q ˉ t ] q ˉ t \bar{q}_t q ˉ t q t ( s t , a t ) q_t(s_t,a_t) q t ( s t , a t ) q ˉ t \bar{q}_t q ˉ t q t ( s t , a t ) − q ˉ t q_{t} (s_t, a_t) - {\bar{q}_t} q t ( s t , a t ) − q ˉ t
不同算法的差异在于 q ˉ t \bar{q}_t q ˉ t
不同算法求解的公式也不同:
🟡值函数近似(Value function approximation)
在先前的方法中,状态/动作值均以表格的(tabular)形式呈现。但是当状态/动作空间较大或者连续时,以上算法会面临存储开销和泛化能力的问题。因此,考虑通过特定函数的形式近似状态值。
Basic idea
A simple example
假设状态值 v ( s ) v(s) v ( s ) s s s v ^ ( s , w ) \hat{v}(s, w) v ^ ( s , w ) v ( s ) v(s) v ( s )
其中, w w w ϕ ( s ) \phi(s) ϕ ( s ) s s s w w w a a a b b b
值函数近似的idea :使用参数化(parameterized)的函数近似状态和动作值,即 v ^ ( s , w ) ≈ v π ( s ) \hat{v}(s, w) \approx v_\pi(s) v ^ ( s , w ) ≈ v π ( s ) w ∈ R m w \in \mathbb{R}^m w ∈ R m
好处:
(1) 便于存储:只需要存储参数,不需要存储状态,而参数的维度往往远小于状态的数量;(2) 泛化能力:当访问一个状态后,参数值发生改变,则整个函数估计发生改变,其余未被访问的状态的状态值同样会发生改变,因此不需要访问每个状态来完成学习过程。
目标函数(objective function)
值函数近似的目标是使得估计值尽可能接近真实状态值,其目标函数 为:
J ( w ) = E [ ( v π ( S ) − v ^ ( S , w ) ) 2 ] J(w) = \mathbb{E} [ (v_\pi(S) - \hat{v}(S,w))^2 ] J ( w ) = E [( v π ( S ) − v ^ ( S , w ) ) 2 ]
值函数近似的目标,即找到能够使得 J ( w ) J(w) J ( w ) w w w
其中, S ∈ S S \in \mathcal{S} S ∈ S
直观理解:如果一个agent按照一个给定策略运行了足够久,其马尔可夫过程最终会达到一个平稳状态【即模型(状态转移概率)是稳定的】。
设 { d π ( s ) } s ∈ S \{ d_\pi (s) \}_{s\in \mathcal{S}} { d π ( s ) } s ∈ S π \pi π d π ( s ) ≥ 0 d_\pi (s) \geq 0 d π ( s ) ≥ 0 ∑ s ∈ S d π ( s ) = 1 \sum_{s\in \mathcal{S}} d_\pi(s) =1 ∑ s ∈ S d π ( s ) = 1
J ( w ) = E [ ( v π ( S ) − v ^ ( S , w ) ) 2 ] = ∑ s ∈ S d π ( s ) ( v π ( S ) − v ^ ( S , w ) ) 2 J(w) = \mathbb{E} [ (v_\pi(S) - \hat{v}(S,w))^2 ] = \sum_{s\in \mathcal{S}} d_\pi (s) (v_\pi(S) - \hat{v}(S,w))^2 J ( w ) = E [( v π ( S ) − v ^ ( S , w ) ) 2 ] = ∑ s ∈ S d π ( s ) ( v π ( S ) − v ^ ( S , w ) ) 2 d π ( s ) d_\pi (s) d π ( s ) s s s
优化算法(optimization algorithm)
采用随机梯度下降(SGD)算法优化(最小化)目标函数 J ( w ) J(w) J ( w ) w t + 1 = w t − α t ( v π ( s t ) − v ^ ( s t , w t ) ) ∇ w v ^ ( s t , w t ) w_{t+1} = w_t - \alpha_t (v_\pi(s_t) - \hat{v}(s_t, w_t)) \nabla_w \hat{v}(s_t, w_t) w t + 1 = w t − α t ( v π ( s t ) − v ^ ( s t , w t )) ∇ w v ^ ( s t , w t )
注意到其中 v π ( s t ) v_\pi(s_t) v π ( s t )
MC with 值函数近似 :用 g t g_t g t s t s_t s t v π ( s t ) v_\pi(s_t) v π ( s t )
w t + 1 = w t − α t ( g t − v ^ ( s t , w t ) ) ∇ w v ^ ( s t , w t ) w_{t+1} = w_t - \alpha_t (g_t - \hat{v}(s_t, w_t)) \nabla_w \hat{v}(s_t, w_t) w t + 1 = w t − α t ( g t − v ^ ( s t , w t )) ∇ w v ^ ( s t , w t )
TD with 值函数近似 :用 r t + 1 + γ v ^ ( s t + 1 , w t ) r_{t+1} + \gamma \hat{v}(s_{t+1}, w_t) r t + 1 + γ v ^ ( s t + 1 , w t ) v π ( s t ) v_\pi(s_t) v π ( s t )
w t + 1 = w t − α t [ r t + 1 + γ v ^ ( s t + 1 , w t ) − v ^ ( s t , w t ) ] ∇ w v ^ ( s t , w t ) w_{t+1} = w_t - \alpha_t [r_{t+1} + \gamma \hat{v}(s_{t+1}, w_t) - \hat{v}(s_t, w_t)] \nabla_w \hat{v}(s_t, w_t) w t + 1 = w t − α t [ r t + 1 + γ v ^ ( s t + 1 , w t ) − v ^ ( s t , w t )] ∇ w v ^ ( s t , w t ) TD target: r t + 1 + γ v ^ ( s t + 1 , w t ) r_{t+1} + \gamma \hat{v}(s_{t+1}, w_t) r t + 1 + γ v ^ ( s t + 1 , w t )
实际上这种方法并不是在优化原本的目标函数,而是在优化另一个相关的目标函数,称作projected Bellman error(详细内容略)
v ^ ( s , w ) \hat{v} (s, w) v ^ ( s , w ) v ^ ( s , w ) \hat{v} (s, w) v ^ ( s , w )
Sarsa / Q-learning with function approximation
Sarsa with function approximation
其实就是把TD with function approximation中的状态值换为动作值:w t + 1 = w t + α t [ r t + 1 + γ q ^ ( s t + 1 , a t + 1 , w t ) − q ^ ( s t , a t , w t ) ] ∇ w q ^ ( s t , a t , w t ) w_{t+1} = w_t + \alpha_t [r_{t+1} + \gamma \hat{q}(s_{t+1}, a_{t+1}, w_t) - \hat{q}(s_t, a_t, w_t)] \nabla_w \hat{q}(s_t, a_t, w_t) w t + 1 = w t + α t [ r t + 1 + γ q ^ ( s t + 1 , a t + 1 , w t ) − q ^ ( s t , a t , w t )] ∇ w q ^ ( s t , a t , w t )
和 Tabular Sarsa 的区别:不是直接更新动作值 q ( s , a ) q(s,a) q ( s , a ) w w w
采用 ε-Greedy 方法进行策略提升:π k + 1 ( a ∣ s t ) = { 1 − ε ∣ A ( s ) ∣ ( ∣ A ( s ) ∣ − 1 ) , i f a = a r g max a ∈ A ( s t ) q ^ t ( s t , a , ω t + 1 ) ε ∣ A ( s ) ∣ , o t h e r w i s e \pi_{k+1}(a|s_t) = \begin{cases} 1− \frac{\varepsilon}{|A(s)|}(|A(s)|−1), & if \ a = arg \max_{a \in \mathcal{A}(s_{t})} \ \hat q_{t}(s_t,a, \omega_{t+1}) \\ \frac{\varepsilon}{|A(s)|}, & otherwise \end{cases} π k + 1 ( a ∣ s t ) = { 1 − ∣ A ( s ) ∣ ε ( ∣ A ( s ) ∣ − 1 ) , ∣ A ( s ) ∣ ε , i f a = a r g max a ∈ A ( s t ) q ^ t ( s t , a , ω t + 1 ) o t h er w i se
注意其中的 q ^ ( s t , a , w t + 1 ) \hat{q}(s_t, a, w_{t+1}) q ^ ( s t , a , w t + 1 )
Q-learning with function approximation
w t + 1 = w t + α t [ r t + 1 + γ max a ∈ A ( s t + 1 ) q ^ ( s t + 1 , a t , w t ) − q ^ ( s t , a t , w t ) ] ∇ w q ^ ( s t , a t , w t ) w_{t+1} = w_t + \alpha_t [r_{t+1} + \gamma {\color{red} \max_{a \in \mathcal{A}(s_{t+1})} \hat{q}(s_{t+1}, a_{t}, w_t)} - \hat{q}(s_t, a_t, w_t)] \nabla_w \hat{q}(s_t, a_t, w_t) w t + 1 = w t + α t [ r t + 1 + γ m a x a ∈ A ( s t + 1 ) q ^ ( s t + 1 , a t , w t ) − q ^ ( s t , a t , w t )] ∇ w q ^ ( s t , a t , w t )
⭐DQN (Deep Q-learning)
尽管在Q-learning with function approximation中,可以使用神经网络作为 q ^ ( s , a , w ) \hat{q} (s, a, w) q ^ ( s , a , w )
DQN的目标函数/损失(loss)函数 :
J ( w ) = E [ ( R + γ max α ∈ A ( S ′ ) q ^ ( S ′ , a , w ) − q ^ ( S , A , w ) ) 2 ] J(w) = \mathbb{E} \Big[ \Big(R + \gamma \max_{\alpha \in \mathcal{A} (S') } \hat{q} (S', a, w) - \hat{q} (S, A ,w) \Big) ^2 \Big] J ( w ) = E [ ( R + γ max α ∈ A ( S ′ ) q ^ ( S ′ , a , w ) − q ^ ( S , A , w ) ) 2 ]
其中, ( S , A , R , S ′ ) (S,A,R,S') ( S , A , R , S ′ ) R + γ max α ∈ A ( S ′ ) q ^ ( S ′ , a , w ) − q ^ ( S , A , w ) R + \gamma \max_{\alpha \in \mathcal{A} (S') } \hat{q} (S', a, w) - \hat{q} (S, A ,w) R + γ max α ∈ A ( S ′ ) q ^ ( S ′ , a , w ) − q ^ ( S , A , w )
关键技术1:两个网络
直接采用梯度下降优化损失函数并不容易,因为其中两项都包含 w w w y = R + γ max α ∈ A ( S ′ ) q ^ ( S ′ , a , w ) y = R + \gamma \textstyle \max_{\alpha \in \mathcal{A} (S') } \hat{q} (S', a, w) y = R + γ max α ∈ A ( S ′ ) q ^ ( S ′ , a , w ) q ^ ( S , A , w ) \hat{q} (S, A ,w) q ^ ( S , A , w )
main network:对应 q ^ ( S , A , w ) \hat{q} (S, A ,w) q ^ ( S , A , w )
target network:对应 q ^ ( S ′ , a , w T ) \hat{q} (S', a, w_T) q ^ ( S ′ , a , w T )
main network的参数 w w w w T w_T w T w w w w T w_T w T
DQN的basic idea:使用梯度下降(GD)优化损失函数,对应梯度为:
∇ w J = E [ ( R + γ max α ∈ A ( S ′ ) q ^ ( S ′ , a , w T ) − q ^ ( S , A , w ) ) ∇ w q ^ ( S , A , w ) ] \nabla_w J = \mathbb{E} \Big[ \Big(R + \gamma \max_{\alpha \in \mathcal{A} (S') } {\color{red} \hat{q} (S', a, w_T) } - {\color{blue} \hat{q} (S, A ,w) } \Big) {\color{blue} \nabla_w \hat{q} (S, A ,w) } \Big] ∇ w J = E [ ( R + γ max α ∈ A ( S ′ ) q ^ ( S ′ , a , w T ) − q ^ ( S , A , w ) ) ∇ w q ^ ( S , A , w ) ]
训练过程(详见下):在每次迭代中,DQN从回放缓存(replay buffer)中取mini-batch采样 ( s , a , r , s ′ ) {(s, a, r, s')} ( s , a , r , s ′ ) s s s a a a y T = r + γ max α ∈ A ( s ′ ) q ^ ( s ′ , a , w T ) y_T = r + \gamma \textstyle \max_{\alpha \in \mathcal{A} (s') } \hat{q} (s', a, w_T) y T = r + γ max α ∈ A ( s ′ ) q ^ ( s ′ , a , w T ) ( s , a , y T ) { (s, a, y_T) } ( s , a , y T ) ( y T − q ^ ( s , a , w ) ) 2 ( y_T - \hat{q} (s, a ,w) )^2 ( y T − q ^ ( s , a , w ) ) 2 w w w w T w_T w T
关键技术2:经验回放(Experience replay)
DQN在收集经验采样后,将其存储在回放缓存(replay buffer) B = ( s , a , r , s ′ ) \mathcal{B} = { (s, a, r, s') } B = ( s , a , r , s ′ )
均匀分布:对所有 ( s , a ) (s, a) ( s , a ) ( s , a ) (s, a) ( s , a )
这里是把 ( S , A ) (S,A) ( S , A )
回放缓存:经验采样的采集有先后顺序,直接按照其顺序使用可能不满足均匀分布的要求,因此将过往经验先存起来再均匀采样,去除采样间的相关性
实际上经验回放也可以用于tabular Q-learning中,还能提高其采样效率(因为可以重复利用)。
DQN算法步骤(off-policy)
目标:从行为策略 π b \pi_b π b
从回放缓存 B \mathcal{B} B
对于每个采样 ( s , a , r , s ′ ) (s, a, r, s') ( s , a , r , s ′ ) y T = r + γ max α ∈ A ( s ′ ) q ^ ( s ′ , a , w T ) y_T = r + \gamma \textstyle \max_{\alpha \in \mathcal{A} (s') } \hat{q} (s', a, w_T) y T = r + γ max α ∈ A ( s ′ ) q ^ ( s ′ , a , w T ) w T w_T w T
使用mini-batch采样 ( s , a , y T ) { (s, a, y_T) } ( s , a , y T ) ( y T − q ^ ( s , a , w ) ) 2 ( y_T - \hat{q} (s, a ,w) )^2 ( y T − q ^ ( s , a , w ) ) 2
每 C C C w w w w T w_T w T 注意:这里的表述与DQN原论文不同(原论文的NN更高效),但本质是一样的。
🟡策略梯度方法(Policy Gradient Methods)
在先前的内容中,策略用表(tabular)的形式进行表达,其也可以用函数的形式进行表达(尤其是当状态空间或动作空间连续或非常大时),优势在于降低存储开销和提升泛化能力。
之前的方法(值函数近似)称之为 Value-based,而策略梯度(Policy Gradient)和Actor-Critic 均为 Policy-based。Value-based 方法围绕状态值/动作值设计,而 Policy-based 优化关于策略的目标函数,从而直接得到最优策略。
Basic Policy Gradient
将策略表示为参数化函数: π ( a ∣ s , θ ) \pi(a|s, \theta) π ( a ∣ s , θ ) θ ∈ R m \theta \in \mathbb{R} ^m θ ∈ R m π \pi π θ θ \theta θ θ θ π ( a , s , θ ) \pi(a,s, \theta) π ( a , s , θ ) π θ ( a ∣ s ) \pi_\theta(a|s) π θ ( a ∣ s ) π θ ( a , s ) \pi_\theta(a,s) π θ ( a , s )
与tabular representation的区别:
最优策略:不是能够最大化每个状态值的策略,而是能够最大化特定scalar metrics的策略
动作概率:不能直接获取,需要进行计算
策略更新:不能直接更新,需要通过改变参数 θ \theta θ来进行改变
策略梯度方法通过优化指定目标函数 J ( θ ) J(\theta) J ( θ )
θ t + 1 = θ t + α ∇ θ J ( θ t ) \theta_{t+1} = \theta_t + \alpha \nabla_\theta J(\theta_t) θ t + 1 = θ t + α ∇ θ J ( θ t )
目标函数 J ( θ ) J(\theta) J ( θ ) v ˉ π \bar{v}_\pi v ˉ π r ˉ π \bar{r}_\pi r ˉ π γ < 1 \gamma<1 γ < 1 r ˉ π = ( 1 − γ ) v ˉ π \bar{r}_\pi = (1- \gamma) \bar{v}_\pi r ˉ π = ( 1 − γ ) v ˉ π
目标函数1:平均状态值
平均状态值(average state value / average value):v ˉ π = ∑ s ∈ S d ( s ) v π ( s ) = E [ v π ( S ) ] \bar{v}_\pi = \sum_{s\in{\mathcal{S}}} d(s) v_\pi(s) = \mathbb{E}[v_\pi(S)] v ˉ π = ∑ s ∈ S d ( s ) v π ( s ) = E [ v π ( S )] d ( s ) ≥ 0 d(s) \geq 0 d ( s ) ≥ 0 ∑ s ∈ S d ( s ) = 1 \sum_{s\in{\mathcal{S}}} d(s) =1 ∑ s ∈ S d ( s ) = 1 d ( s ) d(s) d ( s ) s s s
其他形式: v ˉ π = E [ ∑ t = 0 ∞ γ t R t + 1 ] \bar{v}_\pi = \mathbb{E} \Big[\sum_{t=0}^{\infty} \gamma^t R_{t+1} \Big] v ˉ π = E [ ∑ t = 0 ∞ γ t R t + 1 ]
向量形式: v ˉ π = d T v π \bar{v}_\pi = d^T v_\pi v ˉ π = d T v π
在常见的情况下, d d d π \pi π d π ( s ) d_\pi(s) d π ( s ) d π T P π = d π T d^T_\pi P_\pi = d^T_\pi d π T P π = d π T P π P_\pi P π
目标函数2:平均单步奖励
平均单步奖励(average one-step reward / average reward)r ˉ π = ∑ s ∈ S d ( s ) r π ( s ) = E [ r π ( S ) ] \bar{r}_\pi = \sum_{s\in{\mathcal{S}}} d(s) r_\pi(s) = \mathbb{E}[r_\pi(S)] r ˉ π = ∑ s ∈ S d ( s ) r π ( s ) = E [ r π ( S )] S ∼ d π S \sim d_\pi S ∼ d π d π d_\pi d π r π ( s ) = ∑ a ∈ A π ( a ∣ s ) r ( s , a ) r_\pi(s) = \sum_{a\in\mathcal{A}} \pi(a|s) r(s, a) r π ( s ) = ∑ a ∈ A π ( a ∣ s ) r ( s , a ) π \pi π s s s r ( s , a ) = E [ R ∣ s , a ] = ∑ r r p ( r ∣ s , a ) r(s, a) = \mathbb{E} [R|s, a] = \sum_r r p(r | s, a) r ( s , a ) = E [ R ∣ s , a ] = ∑ r r p ( r ∣ s , a )
另一种形式:( R t + 1 , R t + 2 , ⋯ ) (R_{t+1}, R_{t+2}, \cdots) ( R t + 1 , R t + 2 , ⋯ ) lim n → ∞ 1 n E [ ∑ k = 1 n R t + k ∣ S t = s 0 ] \lim_{n \to \infty} \frac{1}{n} \mathbb{E} \Big[ \sum_{k=1}^{n} R_{t+k} | S_t = s_0 \Big] lim n → ∞ n 1 E [ ∑ k = 1 n R t + k ∣ S t = s 0 ] s 0 s_0 s 0 lim n → ∞ 1 n E [ ∑ k = 1 n R t + k ] = r ˉ π \lim_{n \to \infty} \frac{1}{n} \mathbb{E} \Big[ \sum_{k=1}^{n} R_{t+k} \Big] = \bar{r}_\pi lim n → ∞ n 1 E [ ∑ k = 1 n R t + k ] = r ˉ π
PG梯度计算
策略梯度方法的梯度计算可以统一总结为下式:∇ θ J ( θ ) = ∑ s ∈ S η ( s ) ∑ a ∈ A ∇ θ π ( a ∣ s , θ ) q π ( s , a ) \nabla_\theta J(\theta) = \sum_{s\in\mathcal{S}} \eta (s) \sum_{a\in\mathcal{A}} \nabla_\theta \pi (a|s, \theta) q_\pi(s, a) ∇ θ J ( θ ) = ∑ s ∈ S η ( s ) ∑ a ∈ A ∇ θ π ( a ∣ s , θ ) q π ( s , a )
J ( θ ) J(\theta) J ( θ ) v ˉ π \bar{v}_\pi v ˉ π r ˉ π \bar{r}_\pi r ˉ π v ˉ π 0 \bar{v}_\pi^0 v ˉ π 0 = = = ≈ \approx ≈ ∝ \propto ∝ η \eta η d π d_\pi d π
进一步地,可以基于下式计算梯度 :
∇ θ J ( θ ) = E [ ∇ θ ln π ( A ∣ S , θ ) q π ( S , A ) ] \nabla_\theta J(\theta) = \mathbb{E} [\nabla_\theta \ln\pi (A|S, \theta) q_\pi(S, A) ] ∇ θ J ( θ ) = E [ ∇ θ ln π ( A ∣ S , θ ) q π ( S , A )]
其中, S ∼ η S\sim\eta S ∼ η A ∼ π ( A ∣ S , θ ) A\sim\pi(A|S, \theta) A ∼ π ( A ∣ S , θ )
∇ θ J ( θ ) ≈ ∇ θ ln π ( A ∣ S , θ ) q π ( S , A ) \nabla_\theta J(\theta) \approx \nabla_\theta \ln\pi (A|S, \theta) q_\pi(S, A) ∇ θ J ( θ ) ≈ ∇ θ ln π ( A ∣ S , θ ) q π ( S , A )
注意:为了计算对数 ln \ln ln s , a , θ s, a,\theta s , a , θ π ( a ∣ s , θ ) > 0 \pi(a|s, \theta) > 0 π ( a ∣ s , θ ) > 0 Actor-Critic 中的DPG)( − ∞ , + ∞ ) (-\infty,+\infty) ( − ∞ , + ∞ ) ( 0 , 1 ) (0,1) ( 0 , 1 )
π ( a ∣ s , θ ) = e h ( s , a , θ ) ∑ a ′ ∈ A e h ( s , a ′ , θ ) \pi(a|s, \theta) = \frac{e^{h(s, a, \theta)}}{\textstyle\sum_{a' \in \mathcal{A}} e^{h(s, a', \theta)}} π ( a ∣ s , θ ) = ∑ a ′ ∈ A e h ( s , a ′ , θ ) e h ( s , a , θ )
其中, h ( s , a , θ ) h(s, a, \theta) h ( s , a , θ )
推导:d ln x d x = 1 x \frac{\mathrm{d} \ln x}{\mathrm{d} x} = \frac{1}{x} d x d l n x = x 1 ∇ ln f ( x ) = ∇ f ( x ) f ( x ) \nabla \ln f(x) = \frac{\nabla f(x)}{f(x)} ∇ ln f ( x ) = f ( x ) ∇ f ( x ) ∇ θ ln π ( a ∣ s , θ ) = ∇ θ π ( a ∣ s , θ ) π ( a ∣ s , θ ) \nabla_\theta \ln \pi(a|s, \theta) = \frac{\nabla_\theta \pi(a|s, \theta)}{\pi(a|s, \theta)} ∇ θ ln π ( a ∣ s , θ ) = π ( a ∣ s , θ ) ∇ θ π ( a ∣ s , θ ) π \pi π ∇ θ π ( a ∣ s , θ ) = π ( a ∣ s , θ ) ∇ θ ln π ( a ∣ s , θ ) {\nabla_\theta \pi(a|s, \theta)} = {\pi(a|s, \theta)} \nabla_\theta \ln \pi(a|s, \theta) ∇ θ π ( a ∣ s , θ ) = π ( a ∣ s , θ ) ∇ θ ln π ( a ∣ s , θ )
REINFORCE
策略梯度(PG)方法基于梯度上升方法最大化目标函数:
θ t + 1 = θ t + α E [ ∇ θ ln π ( A ∣ S , θ t ) q π ( S , A ) ] \theta_{t+1} = \theta_t + \alpha \mathbb{E} \big[ \nabla_\theta \ln\pi (A|S, \theta_t) q_\pi(S, A) \big] θ t + 1 = θ t + α E [ ∇ θ ln π ( A ∣ S , θ t ) q π ( S , A ) ]
实际中,通过随机采样的方式估计期望与 q π ( s t , a t ) q_\pi(s_t, a_t) q π ( s t , a t )
θ t + 1 = θ t + α ∇ θ ln π ( a t ∣ s t , θ t ) q t ( s t , a t ) \theta_{t+1} = \theta_t + \alpha \nabla_\theta \ln\pi (a_t|s_t, \theta_t) q_t(s_t, a_t) θ t + 1 = θ t + α ∇ θ ln π ( a t ∣ s t , θ t ) q t ( s t , a t )
注意:A ∼ π ( A ∣ S , θ ) A\sim\pi(A|S,\theta) A ∼ π ( A ∣ S , θ ) a t a_t a t s t s_t s t π ( θ t ) \pi(\theta_t) π ( θ t )
估计 q π ( s t , a t ) q_\pi(s_t,a_t) q π ( s t , a t )
REINFORCE算法步骤 (伪代码):π ( a ∣ s , θ ) \pi(a|s, \theta) π ( a ∣ s , θ ) γ ∈ ( 0 , 1 ) \gamma \in (0,1) γ ∈ ( 0 , 1 ) α > 0 \alpha >0 α > 0 J ( θ ) J(\theta) J ( θ ) k k k π ( θ k ) \pi(\theta_k) π ( θ k ) s 0 s_0 s 0 s 0 , a 0 , r 1 , ⋯ , s T − 1 , a T − 1 , r T { s_0, a_0, r_1, \cdots, s_{T-1}, a_{T-1}, r_T } s 0 , a 0 , r 1 , ⋯ , s T − 1 , a T − 1 , r T
在每个时间步 t = 0 , 1 , ⋯ , T − 1 t=0,1,\cdots, T - 1 t = 0 , 1 , ⋯ , T − 1
值更新(蒙特卡洛方法):q t ( s t , a t ) = ∑ k = t + 1 T γ k − t − 1 r k q_t(s_t,a_t) = \textstyle \sum_{k=t+1}^T \gamma^{k-t-1} r_k q t ( s t , a t ) = ∑ k = t + 1 T γ k − t − 1 r k
策略更新:更新参数 θ t + 1 \theta_{t+1} θ t + 1
*注意:蒙特卡洛是offline的,需要整个episode的数据,所以这里更新完参数后不立即使用策略去采集数据
θ k = θ T \theta_k = \theta_T θ k = θ T
🟡演员-评论家模型(Actor-Critic Methods)
Actor-Critic属于策略梯度(PG) 方法,实际上是将值函数近似 和策略梯度方法进行了结合。
Actor:策略更新,Actor用来执行动作与环境交互
Critic:策略评估 / 值估计,Critic用来评估Actor的好坏
Basic actor-critic / QAC
与策略梯度算法对应,Actor即为策略梯度算法中执行策略更新的部分(通过更新参数 θ \theta θ),而Critic是估计 q t ( s t , a t ) q_t(s_t,a_t) q t ( s t , a t )
QAC vs. REINFOCE:估计 q t ( s t , a t ) q_t(s_t,a_t) q t ( s t , a t )
REINFORCE:蒙特卡洛(MC)
QAC:时序差分(TD)
QAC算法 :【简单理解:QAC = Sarsa with function estimation + Policy Gradient 】
Critic(值更新 / 策略评估):采用Sarsa with function estimation的方法估计 q t ( s t , a t ) q_t(s_t,a_t) q t ( s t , a t )
w t + 1 = w t + α w [ r t + 1 + γ q ( s t + 1 , a t + 1 , w t ) − q ( s t , a t , w t ) ] ∇ w q ( s t , a t , w t ) w_{t+1} = w_t + \alpha_w [r_{t+1} + \gamma {q}(s_{t+1}, a_{t+1}, w_t) - {\color{blue} {q}(s_t, a_t, w_t)}] {\color{blue} \nabla_w {q}(s_t, a_t, w_t)} w t + 1 = w t + α w [ r t + 1 + γ q ( s t + 1 , a t + 1 , w t ) − q ( s t , a t , w t ) ] ∇ w q ( s t , a t , w t )
Actor(策略更新 / 策略提升):采用策略梯度(PG)的方法(同REINFROCE)更新策略
θ t + 1 = θ t + α θ ∇ θ ln π ( a t ∣ s t , θ t ) q t ( s t , a t , w t + 1 ) \theta_{t+1} = \theta_t + \alpha_\theta \nabla_\theta \ln\pi (a_t|s_t, \theta_t) {\color{blue} q_t(s_t, a_t, w_{t+1}) } θ t + 1 = θ t + α θ ∇ θ ln π ( a t ∣ s t , θ t ) q t ( s t , a t , w t + 1 )
A2C (Advantage actor-critic)
A2C的基本思想:在QAC中引入baseline来减少估计的方差(variance)。
理论基础:引入baseline b ( S ) b(S) b ( S ) ∇ θ J ( θ ) = E S ∼ η , A ∼ π [ ∇ θ ln π ( A ∣ S , θ ) q π ( S , A ) ] = E S ∼ η , A ∼ π [ ∇ θ ln π ( A ∣ S , θ ) ( q π ( S , A ) − b ( S ) ) ] \nabla_\theta J (\theta) = \mathbb{E}_{S\sim\eta,A\sim\pi} [\nabla_\theta \ln\pi (A|S, \theta) q_\pi(S, A) ] = \mathbb{E}_{S\sim\eta,A\sim\pi} [\nabla_\theta \ln\pi (A|S, \theta) (q_\pi(S, A) {\color{blue} - b(S))} ] ∇ θ J ( θ ) = E S ∼ η , A ∼ π [ ∇ θ ln π ( A ∣ S , θ ) q π ( S , A )] = E S ∼ η , A ∼ π [ ∇ θ ln π ( A ∣ S , θ ) ( q π ( S , A ) − b ( S )) ] b ( S ) b(S) b ( S ) S S S b ∗ ( s ) = E A ∼ π [ ∣ ∇ θ ln π ( A ∣ s , θ t ) ∣ 2 q ( S , A ) ] E A ∼ π [ ∣ ∇ θ ln π ( A ∣ s , θ t ) ∣ 2 ] b^*(s) = \frac{ \mathbb{E}_{A\sim\pi} [ {\color{blue} | \nabla_\theta \ln\pi (A|s, \theta_t) |^2} {\color{red} q(S,A)} ] }{ \mathbb{E}_{A\sim\pi} [ {\color{blue} | \nabla_\theta \ln\pi (A|s, \theta_t) |^2} ] } b ∗ ( s ) = E A ∼ π [ ∣ ∇ θ l n π ( A ∣ s , θ t ) ∣ 2 ] E A ∼ π [ ∣ ∇ θ l n π ( A ∣ s , θ t ) ∣ 2 q ( S , A ) ] ∣ ∣ ∇ θ ln π ( A ∣ s , θ t ) ∣ ∣ 2 || \nabla_\theta \ln\pi (A|s, \theta_t) ||^2 ∣∣ ∇ θ ln π ( A ∣ s , θ t ) ∣ ∣ 2 b ( s ) = E A ∼ π [ q ( S , A ) ] = v π ( s ) b(s) = \mathbb{E}_{A\sim\pi} [q(S,A)] = v_\pi(s) b ( s ) = E A ∼ π [ q ( S , A )] = v π ( s ) s s s
在 actor(策略更新)中引入状态值作为baseline ,即:
θ t + 1 = θ t + α E [ ∇ θ ln π ( A ∣ S , θ t ) [ q π ( S , A ) − v π ( s ) ] ] = θ t + α E [ ∇ θ ln π ( A ∣ S , θ t ) δ π ( S , A ) ] \theta_{t+1} = \theta_{t} + \alpha \mathbb{E} [\nabla_\theta \ln\pi (A|S, \theta_t) [ q_\pi(S, A) - v_{\pi} (s)] ] = \theta_{t} + \alpha \mathbb{E} [\nabla_\theta \ln\pi (A|S, \theta_t) \delta_\pi(S, A) ] θ t + 1 = θ t + α E [ ∇ θ ln π ( A ∣ S , θ t ) [ q π ( S , A ) − v π ( s )]] = θ t + α E [ ∇ θ ln π ( A ∣ S , θ t ) δ π ( S , A )]
其中, δ π ( S , A ) = q π ( S , A ) − v π ( S ) \delta_\pi(S, A) = q_\pi(S, A) - v_\pi (S) δ π ( S , A ) = q π ( S , A ) − v π ( S )
θ t + 1 = θ t + α ∇ θ ln π ( a t ∣ s t , θ t ) [ q π ( s t , a t ) − v t ( s t ) ] = θ t + α ∇ θ ln π ( a t ∣ s t , θ t ) δ π ( s t , a t ) \theta_{t+1} = \theta_{t} + \alpha \nabla_\theta \ln\pi (a_t|s_t, \theta_t) [ q_\pi(s_t, a_t) - v_{t} (s_t) ] = \theta_{t} + \alpha \nabla_\theta \ln\pi (a_t|s_t, \theta_t) \delta_\pi(s_t, a_t) θ t + 1 = θ t + α ∇ θ ln π ( a t ∣ s t , θ t ) [ q π ( s t , a t ) − v t ( s t )] = θ t + α ∇ θ ln π ( a t ∣ s t , θ t ) δ π ( s t , a t )
进一步地,优势函数可以由TD error近似(推导略),好处是只需要一个神经网络近似 v t v_t vt即可,不需要再近似 q t q_t qt。这就是A2C(也称为TD actor-critic)算法,其优势函数 的具体形式为:
δ t = r t + 1 + γ v t ( s t + 1 ) − v t ( s t ) \delta_t = r_{t+1} + \gamma v_{t} (s_{t+1}) - v_t (s_t) δ t = r t + 1 + γ v t ( s t + 1 ) − v t ( s t )
*注:
优势函数在文献中通常记作 A
这里的直觉是,动作值的相对值比其绝对值更重要
A2C的完整算法 (on-policy):
TD error(优势函数): δ t = r t + 1 + γ v t ( s t + 1 ) − v t ( s t ) {\color{darkred} \delta_t} = r_{t+1} + \gamma v_{t} (s_{t+1}) - v_t (s_t) δ t = r t + 1 + γ v t ( s t + 1 ) − v t ( s t )
Critic(值更新 / 策略评估): w t + 1 = w t + α w δ t ∇ w v ( s t , w t ) w_{t+1} = w_t + \alpha_w {\color{darkred} \delta_t} {\nabla_w {v}(s_t, w_t)} w t + 1 = w t + α w δ t ∇ w v ( s t , w t )
*注意这里与QAC的区别:QAC用的是Sarsa,A2C用的是TD,因此这里用状态值而非动作值
Actor(策略更新 / 策略提升): θ t + 1 = θ t + α θ δ t ∇ θ ln π ( a t ∣ s t , θ t ) \theta_{t+1} = \theta_t + \alpha_\theta {\color{darkred} \delta_t} \nabla_\theta \ln\pi (a_t|s_t, \theta_t) θ t + 1 = θ t + α θ δ t ∇ θ ln π ( a t ∣ s t , θ t )
Off-policy AC
AC 算法本身是on-policy的,但是可以通过重要性采样(Importance Sampling) 将其转为off-policy算法。
重要性采样(Importance Sampling)
重要性采样:基于概率分布 p 1 p_1 p 1 X X X p 0 p_0 p 0 X X X E [ X ] \mathbb{E}[X] E [ X ] p 0 p_0 p 0 X X X p 1 p_1 p 1 X X X p 0 p_0 p 0 p 0 p_0 p 0
E X ∼ p 0 [ X ] = ∑ x p 0 ( x ) x = ∑ x p 1 ( x ) p 0 ( x ) p 1 ( x ) x ⏟ f ( x ) = E X ∼ p 1 [ f ( X ) ] {\color{red} \mathbb{E}_{X\sim p_0} [X] } = \sum_x p_0(x) x = \sum_x {\color{blue} p_1(x)} \underbrace{\frac{p_0(x)}{\color{blue} p_1(x)} x}_{f(x)} = {\color{red} \mathbb{E}_{X\sim p_1} [f (X)] } E X ∼ p 0 [ X ] = ∑ x p 0 ( x ) x = ∑ x p 1 ( x ) f ( x ) p 1 ( x ) p 0 ( x ) x = E X ∼ p 1 [ f ( X )]
其中, [ f ( X ) ] E X ∼ p 1 [f (X)] EX∼p1 [ f ( X )] E X ∼ p 1 f ( X ) f(X) f ( X )
E X ∼ p 0 [ X ] ≈ f ˉ = 1 n ∑ i = 1 n f ( x i ) = 1 n ∑ i = 1 n p 0 ( x i ) p 1 ( x i ) x i {\color{red} \mathbb{E}_{X\sim p_0} [X] } \approx \bar{f} = \frac{1}{n} \sum_{i=1}^{n} f(x_i) {\color{red} = \frac{1}{n} \sum_{i=1}^{n} {\color{blue} \frac{p_0(x_i)}{p_1(x_i)} } x_i } E X ∼ p 0 [ X ] ≈ f ˉ = n 1 ∑ i = 1 n f ( x i ) = n 1 ∑ i = 1 n p 1 ( x i ) p 0 ( x i ) x i
其中, p 0 ( x i ) p 1 ( x i ) \frac{p_0(x_i)}{p_1(x_i)} p 1 ( x i ) p 0 ( x i ) x i x_i x i p 0 p_0 p 0 p 1 p_1 p 1
Off-policy PG
由行为策略 β \beta β
J ( θ ) = ∑ s ∈ S d β ( s ) v π ( s ) = E S ∼ d β [ v π ( S ) ] J(\theta) = \sum_{s \in \mathcal{S}} d_\beta (s) v_\pi (s) = \mathbb{E}_{S \sim d_\beta} [v_\pi (S)] J ( θ ) = ∑ s ∈ S d β ( s ) v π ( s ) = E S ∼ d β [ v π ( S )]
其中, d β d_\beta d β β \beta β 策略梯度 中 J ( θ ) J(\theta) J ( θ ) v ˉ π \bar{v}_\pi v ˉ π
∇ θ J ( θ ) = E S ∼ ρ , A ∼ β [ π ( A ∣ S , θ ) β ( A ∣ S ) ∇ θ ln π ( A ∣ S , θ ) q π ( S , A ) ] \nabla_\theta J(\theta) = \mathbb{E}_{S \sim \rho, A \sim \beta} \Big[ \frac{\pi(A|S, \theta)}{\beta(A|S)} \nabla_\theta \ln \pi (A|S, \theta) q_\pi (S, A) \Big] ∇ θ J ( θ ) = E S ∼ ρ , A ∼ β [ β ( A ∣ S ) π ( A ∣ S , θ ) ∇ θ ln π ( A ∣ S , θ ) q π ( S , A ) ]
式中 ρ \rho ρ π ( A ∣ S , θ ) β ( A ∣ S ) \frac{\pi(A|S, \theta)}{\beta(A|S)} β ( A ∣ S ) π ( A ∣ S , θ ) A ∼ β A \sim \beta A ∼ β A ∼ π A \sim \pi A ∼ π
Off-policy AC
基于前文分析,Off-policy AC的算法为:
θ t + 1 = θ t + α θ π ( a t ∣ s t , θ t ) β ( a t ∣ s t ) ∇ θ l n π ( a t ∣ s t , θ t ) [ r t + 1 + γ v t ( s t + 1 ) − v t ( s t ) ] = θ t + α θ π ( a t ∣ s t , θ t ) β ( a t ∣ s t ) ∇ θ l n π ( a t ∣ s t , θ t ) δ t ( s t , a t ) \theta_{t+1} = \theta_t + \alpha_{\theta} \frac{π(a_t|s_t,θ_t)}{β(a_t|s_t)} \nabla_θlnπ(a_t|s_t,θ_t)[r_{t+1} + γ v_t(s_{t+1})−vt(s_t)]= θ_t + α_θ \frac{π(a_t|s_t,θ_t)}{β(a_t|s_t)} \nabla_θ lnπ(a_t|s_t,θ_t) δ_t(s_t,a_t) θ t + 1 = θ t + α θ β ( a t ∣ s t ) π ( a t ∣ s t , θ t ) ∇ θ l nπ ( a t ∣ s t , θ t ) [ r t + 1 + γ v t ( s t + 1 ) − v t ( s t )] = θ t + α θ β ( a t ∣ s t ) π ( a t ∣ s t , θ t ) ∇ θ l nπ ( a t ∣ s t , θ t ) δ t ( s t , a t )
算法步骤及伪代码类似于A2C,主要是多了重要性权重 π ( a t ∣ s t , θ t ) β ( a t ∣ s t ) \frac{\pi(a_t|s_t, \theta_t)}{\beta(a_t|s_t)} β ( a t ∣ s t ) π ( a t ∣ s t , θ t )
DPG (Deterministic AC)
先前的PG及AC算法均为随机性(stochastic)策略,实际上也存在确定性(deterministic)策略的AC算法,即DPG(Deterministic Policy Gradient)。
确定性策略记作: a = μ ( s , θ ) a = \mu (s, \theta) a = μ ( s , θ ) μ ( s ) \mu (s) μ ( s ) μ \mu μ S \mathcal{S} S A \mathcal{A} A
DPG为off-policy方法(动作不依赖于具体策略),其梯度计算如下:
∇ θ J ( θ ) = ∑ s ∈ S ρ μ ( s ) ∇ θ μ ( s ) ( ∇ a q μ ( s , a ) ) ∣ a = μ ( s ) = E S ∼ ρ μ [ ∇ θ μ ( s ) ( ∇ a q μ ( s , a ) ) ∣ a = μ ( s ) ] \nabla_θ J ( θ ) = \sum_{s ∈ S} ρ_μ ( s ) \nabla_θ μ ( s ) ( \nabla_a q μ ( s , a ) ) ∣_{a = μ ( s )} = \mathbb{E}_{S∼ρ_μ} [ \nabla_{\theta} \mu(s) ( \nabla_a q_μ ( s , a ) ) ∣_{a = μ ( s )} ] ∇ θ J ( θ ) = ∑ s ∈ S ρ μ ( s ) ∇ θ μ ( s ) ( ∇ a q μ ( s , a )) ∣ a = μ ( s ) = E S ∼ ρ μ [ ∇ θ μ ( s ) ( ∇ a q μ ( s , a )) ∣ a = μ ( s ) ]
其中, ρ μ \rho_\mu ρ μ ( ∇ a q μ ( s , a ) ) ∣ a = μ ( s ) (\nabla_a q_\mu (s, a))|_{a= \mu (s)} ( ∇ a q μ ( s , a )) ∣ a = μ ( s ) q μ ( s , a ) q_\mu(s,a) q μ ( s , a ) a a a a a a μ ( s ) \mu(s) μ ( s )
θ t + 1 = θ t + α θ ∇ θ μ ( s t ) ( ∇ a q μ ( s t , a ) ) ∣ a = μ ( s ) \theta_{t+1} = \theta_t + \alpha_\theta \nabla_\theta \mu(s_t) (\nabla_a q_\mu (s_t, a)) |_{a=\mu(s)} θ t + 1 = θ t + α θ ∇ θ μ ( s t ) ( ∇ a q μ ( s t , a )) ∣ a = μ ( s )
DPG算法步骤 (伪代码):
初始化:行为策略 β ( a ∣ s ) \beta (a|s) β ( a ∣ s ) μ ( s , θ 0 ) \mu(s, \theta_0) μ ( s , θ 0 ) θ 0 \theta_0 θ 0 v ( s , w 0 ) v(s, w_0) v ( s , w 0 ) w 0 w_0 w 0 ∗ β ^*\beta ∗ β μ \mu μ
目标:最大化 J ( θ ) J(\theta) J ( θ ) t t t β \beta β a t a_t a t r t + 1 r_{t+1} r t + 1 s t + 1 s_{t+1} s t + 1
δ t = r t + 1 + γ q ( s t + 1 , μ ( s t + 1 , θ t ) , w t ) − q ( s t , a t , w t ) {\color{darkred} \delta_t} = r_{t+1} + \gamma q(s_{t+1}, \mu(s_{t+1}, \theta_t), w_t) - q(s_t, a_t, w_t) δ t = r t + 1 + γ q ( s t + 1 , μ ( s t + 1 , θ t ) , w t ) − q ( s t , a t , w t )
w t + 1 = w t + α w δ t ∇ w q ( s t , a t , w t ) w_{t+1} = w_t + \alpha_w {\color{darkred} \delta_t} \nabla_w q(s_t, a_t, w_t) w t + 1 = w t + α w δ t ∇ w q ( s t , a t , w t )
,即TD+值函数估计
Actor(策略更新 / 策略提升):θ t + 1 = θ t + α θ ∇ θ μ ( s t , θ t ) ( ∇ a q ( s t , a , w t + 1 ) ) ∣ a = μ ( s t ) \theta_{t+1} = \theta_t + \alpha_\theta \nabla_\theta \mu(s_t, \theta_t) (\nabla_a q (s_t, a, w_{t+1})) |_{a=\mu(s_t)} θ t + 1 = θ t + α θ ∇ θ μ ( s t , θ t ) ( ∇ a q ( s t , a , w t + 1 )) ∣ a = μ ( s t )
注意到DPG中包含了 q ( s , a , w ) q(s,a,w) q ( s , a , w )
线性函数: q ( s , a , w ) = ϕ T ( s , a ) ω q(s,a,w) = \phi^T (s,a) \omega q ( s , a , w ) = ϕ T ( s , a ) ω ϕ ( s , a ) \phi(s,a) ϕ ( s , a )
神经网络:即后续的DDPG(Deep deterministic policy gradient)方法
PPO
相关学习
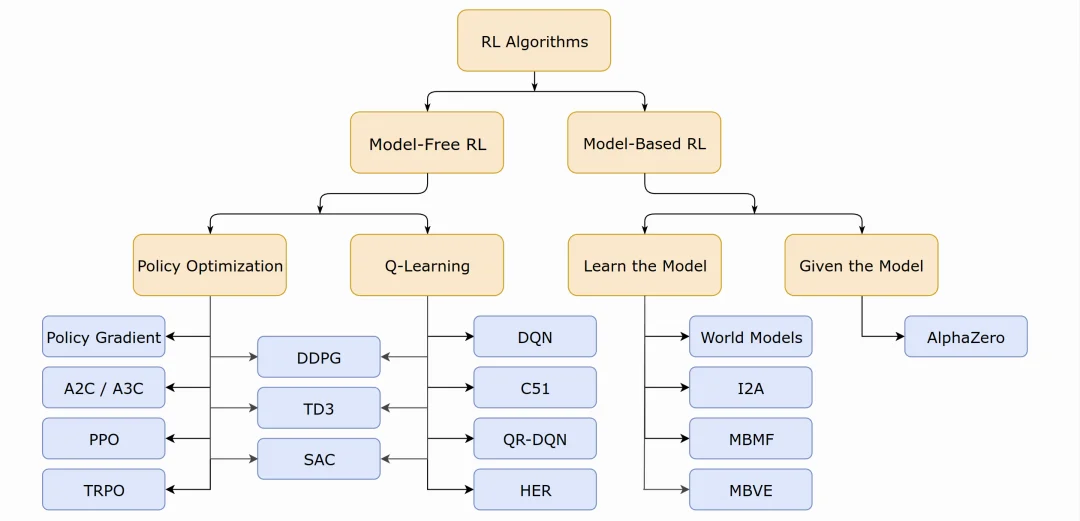
数学描述:
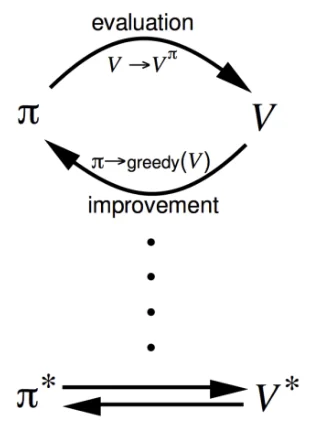

 注:实际上,策略评估与策略提升是一种非常通用的强化学习思想(称为通用策略迭代,GPI),并在许多后续的强化学习方法(如蒙特卡洛方法、时序差分学习等)中有着广泛应用。