一、背景(Background)
在 Transformer 出现之前,自然语言处理主要依赖 RNN、LSTM 这一类模型,它们的核心逻辑是按顺序处理文本,一个词一个词往后传递。你可以把它想象成一个人在读书,只能一行一行往下看,前面的内容需要靠“记忆”保留在脑子里。如果句子很短,这种方式没问题,但一旦句子很长,就像读了一大段话再回忆开头,很多细节就会模糊甚至丢失。这就是为什么模型在处理长文本时,很难抓住关键的前置信息。
行业一直在寻找一种更聪明的方式:不是靠“死记”,而是能随时“回头看”。
二、核心问题(Problem)
Transformer 要解决的,本质上就是三个问题:
第一,如何让模型不再像人一样被迫“顺序阅读”,而是可以像打开一张思维导图一样,一眼看到整句话的结构。 第二,如何让远距离的词之间建立直接联系,就像两个人即使坐在会议室两端,也能直接对话,而不是层层传话。 第三,如何在这种更强理解能力的基础上,还能让模型跑得更快、规模更大,适应真实工业级应用。
三、核心分析(Analysis)
Transformer 的核心在于 Self-Attention,也就是自注意力机制。可以把它理解成:一句话里的每个词,都在参加一场“讨论会”,每个词都可以主动看向其他词,判断谁最重要、谁和自己关系最密切。相比之下,RNN 更像是“排队发言”,而 Transformer 更像是“自由交流”。
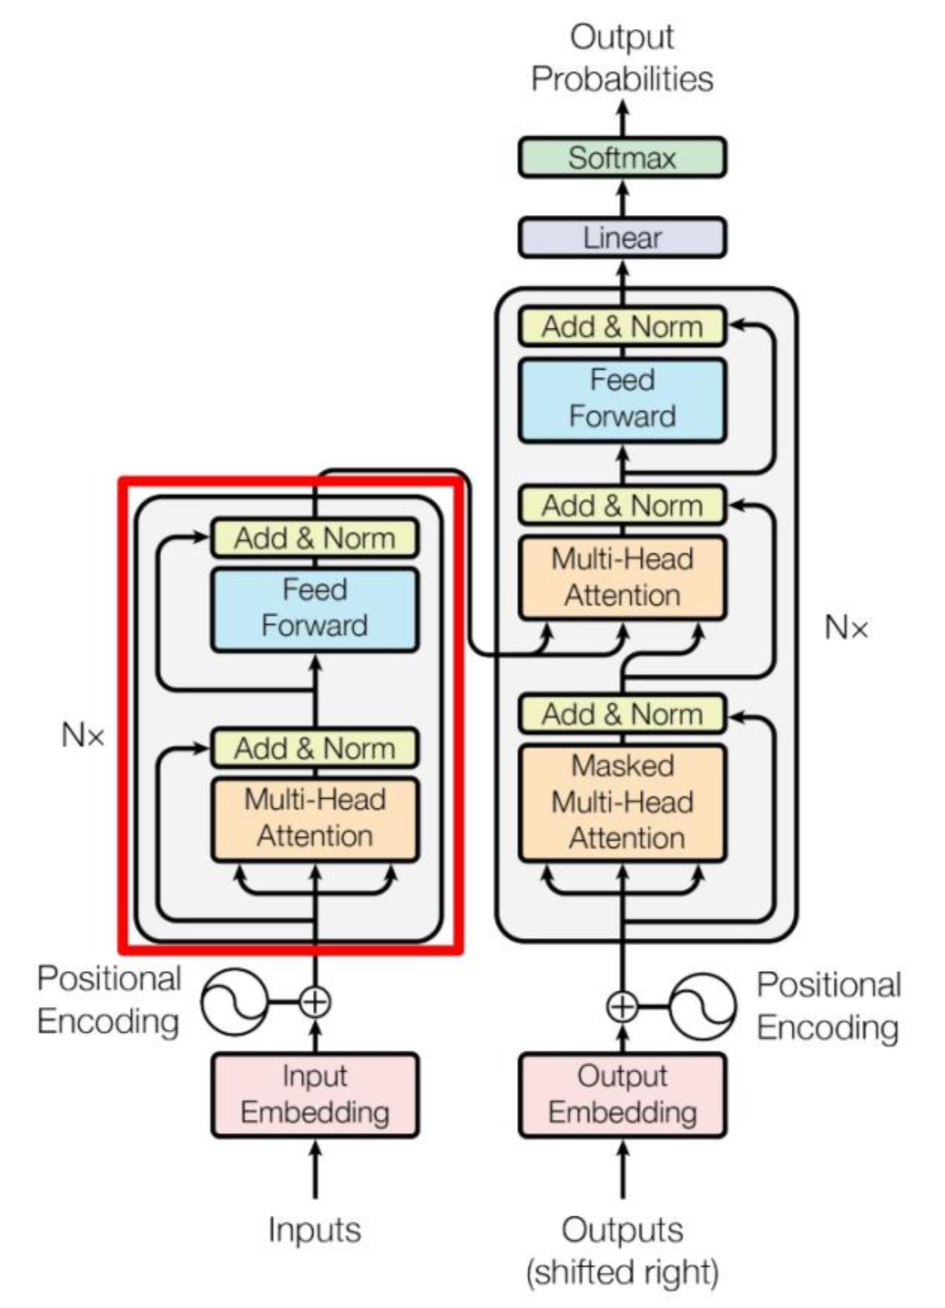
在具体实现上,每个词会被映射为 Query、Key、Value 三个向量。你可以这样理解:Query 是“我想问什么”,Key 是“我能提供什么线索”,Value 是“我真正的内容”。当一个词想理解上下文时,它会拿自己的 Query 去和所有词的 Key 做匹配,找到最相关的几个对象,然后把这些词的 Value 按重要程度加权整合,形成新的理解。就像你在查资料时,会筛选最相关的几篇文章,再综合它们的信息来得出结论。
这个过程带来的最大变化是:词的含义变成“动态的”。比如“bank”这个词,在“river bank”和“bank account”里意思完全不同。Transformer 就像一个能根据上下文实时判断语境的人,而不是死记词典定义。
在整体结构上,Transformer 是多层堆叠的系统。多头注意力可以理解为“多个专家同时分析一句话”,有的关注语法,有的关注语义,有的关注上下文关系;前馈网络则像是对信息做进一步加工,让表达更精细;而残差连接和 LayerNorm 就像是“稳定器”,确保整个系统在变复杂的同时不会失控。此外,Decoder 里的 Mask 机制,可以理解为“写作文时不能偷看后面的答案”,保证生成过程是合理的。
四、解决方案(Solution)
基于 Transformer,目前形成了两类主流路径。第一类是标准 Transformer(Encoder-Decoder),适用于翻译、摘要等任务,可以理解为“先理解,再输出”的完整流程。这种方式就像一个专业翻译官,先完整读懂原文,再输出结果,但缺点是当文本很长时,计算成本会明显上升。
第二类是演化出来的模型形态。比如 BERT 更像一个“阅读理解专家”,专注理解文本;GPT 更像一个“写作高手”,擅长续写和生成内容;而 Longformer、FlashAttention 等优化方案,则是在解决“信息太多处理不过来”的问题,相当于在做“更高效的信息筛选机制”。这些方案本质上都是围绕一个核心:保留 Attention 的能力,同时让它更快、更省资源。
五、总结(Summary)
如果用一个最直观的比喻来总结 Transformer,它就像是把“线性阅读”升级成了“网络式思考”。不再是从头读到尾,而是像在一张关系网中跳跃、连接、理解信息。每个词都不再是孤立的,而是被放在整个语境中不断重新定义。
正是这种从“记忆顺序”到“理解关系”的转变,让 Transformer 成为了 GPT、BERT、Llama 等大模型的底层基础,也成为整个 AI 时代最关键的一块基石。