一、背景(Background)
如果说像Transformer这样的模型解决的是"理解和生成",那强化学习解决的其实是更接近现实世界的问题:如何在不确定环境中做决策。
很多真实场景其实都没有标准答案——自动驾驶怎么走、机器人如何抓取、AI如何玩游戏甚至打败人类。
这类问题不能简单靠"监督学习"去做标注,因为没人能给你每一步的正确答案。于是就有了强化学习(Reinforcement Learning, RL)——让AI像初入江湖的少年一样,不再依赖背诵秘籍,而是通过一次次试错,在跌跌撞撞中自己领悟"什么是对的"。
二、核心问题(Problem)
- 问题1:如何在没有标准答案的情况下训练模型?
- 问题2:模型如何知道"什么是好,什么是坏"?
- 问题3:如何在探索(尝试新策略)和利用(使用已有经验)之间取得平衡?
三、核心分析(Analysis)
1. 强化学习的基本框架:一个永恒的循环
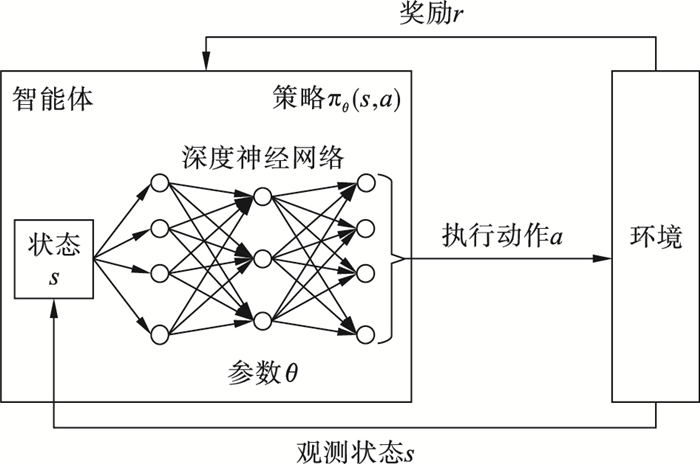
强化学习最核心的结构可以抽象成一个循环:状态(State)→行动(Action)→奖励(Reward)→新状态(Next State)。
想象一只小狗学习开门:它先观察门把手(状态),尝试用爪子扒拉(行动),门开了就得到零食(奖励),门没开就换个角度再试(更新策略)。AI智能体(Agent)也是如此——观察环境、做出决策、获得反馈、更新策略。整个过程本质上是在优化一个目标:最大化长期累计奖励。这不是短视的"眼前利益最大化",而是像下棋高手一样,每一步都在问自己:"现在这么做,十步之后会不会更好?"
关键概念很简单:
- Policy(策略):给定状态,应该采取什么行动
- Value Function(价值函数):当前状态"有多好"
- Reward(奖励):即时反馈
2. 两大路线之争:"打分员"与"决策者"
强化学习的发展史上,最经典的两大路线像是两种截然不同的性格,它们回答同一个问题的思路完全不同:当你面对一个局面,应该怎么做?
- Q-Learning(值函数派)像一个严格的"打分员"。它不直接告诉你该做什么,但能告诉你每个选择值多少分(根据分数进行选择)。想象一位严厉的体育教练,手里有一张详细的评分表:在当前局面下,向左走值85分,向右跳值92分,原地不动值60分。你只需选择分数最高的动作即可。这就是Q-Learning的核心——学习一个Q函数,接收"状态+动作"作为输入,输出这个动作的"预期总回报"。这种方法思路清晰,在离散动作空间表现优异,比如Atari游戏中的上、下、左、右、开火。但遇到连续精细控制就力不从心:机器人手臂转动37.5度和37.6度,你不可能为每一个微小的角度变化都建立打分条目,表格会无限膨胀,计算变得不可行。
- Policy Gradient(策略派)则像一位凭直觉的"决策者"。它不打分,而是直接训练一个能自己决策的大脑。想象经验丰富的老司机,面对复杂路况时不会在脑子里计算"向左打方向盘值多少分",而是凭直觉直接做出反应——看到行人突然窜出,手已经自动打方向、踩刹车。这种直觉是千万次试错积累的结果。Policy Gradient正是如此:用一个神经网络直接接收状态,输出动作的概率分布,通过"做得好就强化、做得差就抑制"来调整参数。它天然适合连续动作空间,从原始输入直接映射到动作,更有表现力。但代价是训练过程像走钢丝,策略更新基于采样得到的轨迹,运气好可能被误导,更新幅度太大性能会断崖式下跌,早期的REINFORCE算法就像一匹烈马,跑得快但随时可能把骑手甩出去。
聪明的研究者很快想到:为什么不能两者结合?
于是诞生了Actor-Critic架构——"打分员"和"决策者"的合体。Actor负责直接做决策,Critic负责评估Actor的表现,告诉它"刚才那步比预期好还是差"。这让训练更稳定,Actor不再需要依赖整场游戏的最终输赢来判断每一步的好坏。PPO正是建立在这种架构之上。
如果说Q-Learning是"先评估再选择"的打分系统,Policy Gradient是"直接行动"的决策者大脑,那么PPO就是"有自知之明的决策者"——它知道自己容易冲动,所以给自己设了道护栏,每次只走一小步,但方向是对的。它既保留了Policy Gradient处理连续动作的灵活性,又通过限制策略更新幅度解决了训练不稳定的问题。这就是为什么,当你和ChatGPT对话时,它既不会机械地背答案,也不会突然胡言乱语,而是恰到好处地"说人话"——这背后,PPO功不可没。
四、解决方案(Solution)
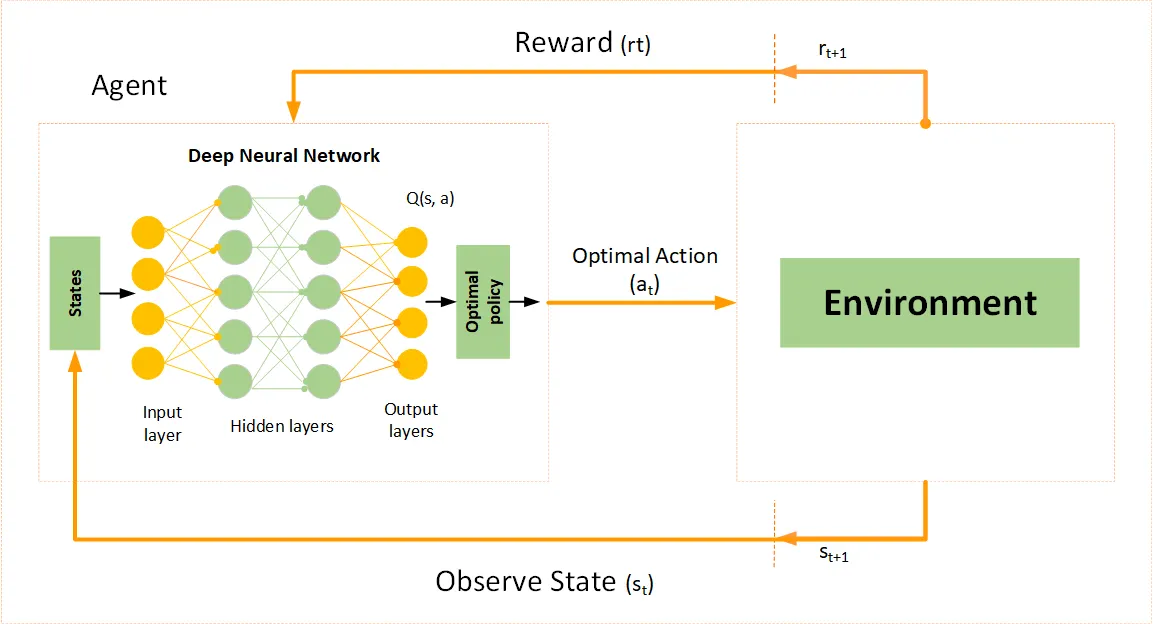
基于值函数的方法(DQN体系),构建一个Q网络,预测每个动作的价值,输入state → 输出每个action的Q值 → 选择最大Q值的action → 用Bellman方程更新网络。核心逻辑是:当前价值 = 即时奖励 + 未来最优价值
DQN体系用"经验回放"来稳定学习过程。它像一位勤做笔记的探险家,把每次经历存入笔记本,然后反复随机翻阅。这种"反刍式学习"打破数据相关性,配合"目标网络"技术——用旧地图评估新位置,防止打分时的乐观偏差。这让DQN在Atari游戏中大放异彩,但它的局限也很明显:面对连续动作空间时,那张"打分表"无法无限延展,就像笔记本再厚也记不下世界上每一条小路。
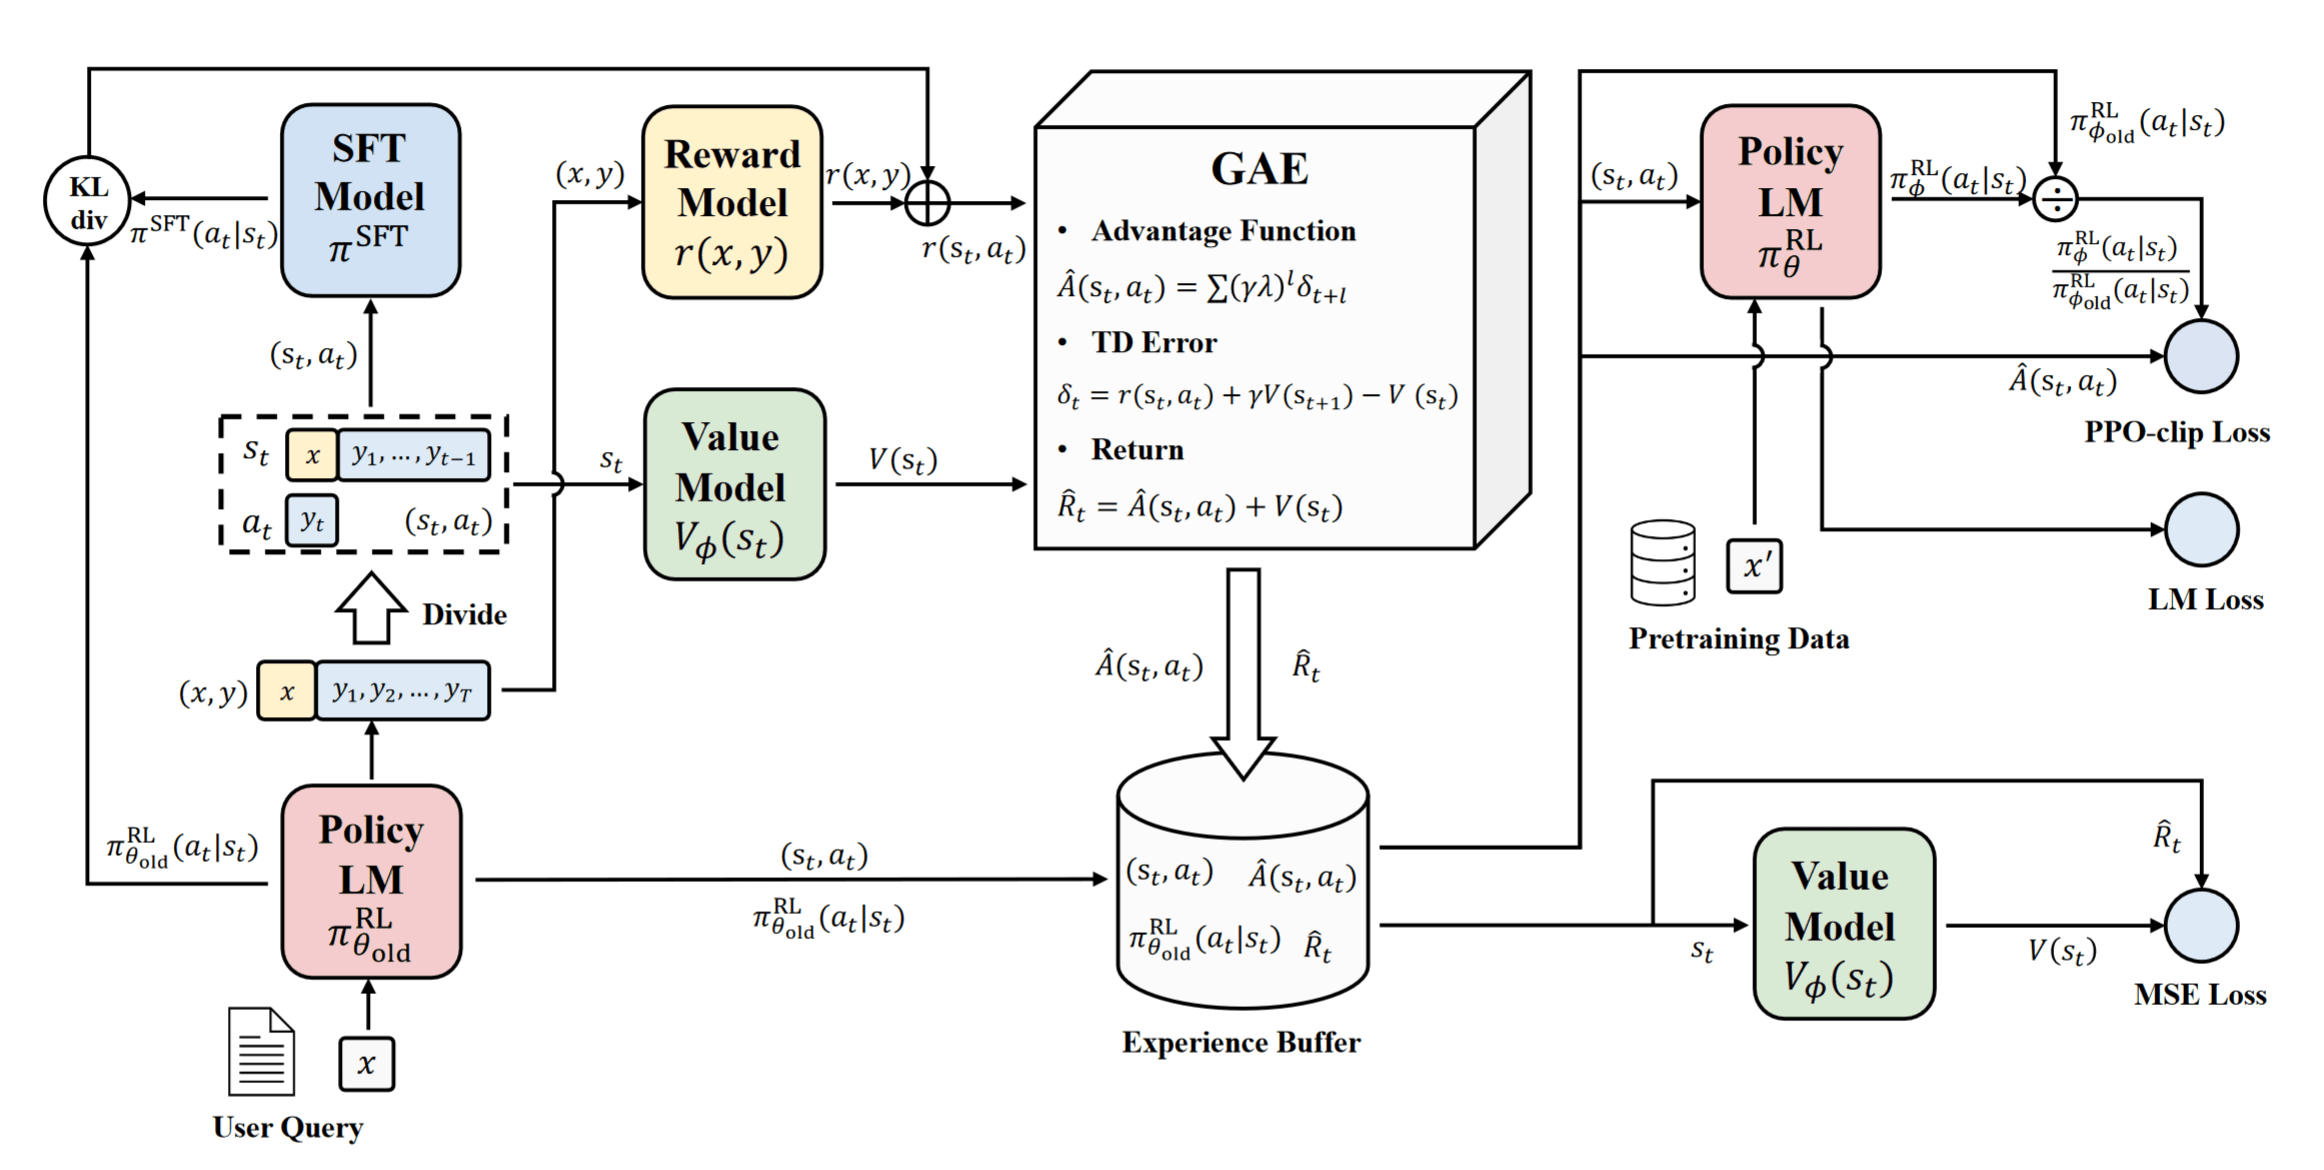
PPO体系则走了一条更直接的路——不再查表打分,而是直接训练"决策者大脑",并让它"稳健进化"。它采样完整轨迹,计算每个动作的"优势函数"(即这个动作比平均水平好多少),然后用这个信号更新策略。关键是,PPO给自己定了一条铁律:新策略不能偏离旧策略太远。通过"裁剪目标函数",它把更新幅度限制在安全区间内,就像给登山队系上了安全绳。这种"保守的勇敢"让它既敢于探索更好的行为,又不会因一时冲动而崩溃。更重要的是,PPO可以在线学习,边采样边更新,不需要囤积海量经验。这正是大模型训练急需的特性:ChatGPT每天处理千万级对话,PPO让它能够实时从人类反馈中进化,既稳步提升,又避免某天突然"性情大变"。
两种方案殊途同归,但适用场景不同:DQN适合离散动作的离线游戏,PPO适合连续动作的在线进化。而在大模型时代,后者显然更契合这场永不停歇的旅程。
五、总结(Summary)
强化学习本质上解决的是一个非常真实的问题:在没有标准答案的世界里,如何做出最优决策。它的核心不是"学习知识",而是学习行为。
从Q-Learning到PPO,本质是一条演化路径:从"评估行为好坏"到"直接学会怎么行动"。如果说深度学习让AI"看懂世界",那强化学习,就是让AI真正"参与世界"。