如果说传统神经网络是"死记硬背的学生",卷积神经网络(Convolutional Neural Network, CNN)就是"会观察会归纳的侦探"——它懂得"先看局部,再拼整体"的智慧。
一、为什么传统神经网络搞不定图片?
想象你要教一个外星人认识"猫":
传统神经网络的做法:把猫的照片拆成300万个数字(像素),一股脑儿塞进一个超长列表里。就像把一幅拼图全部拆散,把拼图碎片混进一个袋子里,然后让外星人从袋子里猜这是什么。
问题很明显:
- 拼图碎片之间的空间拓扑关系全丢了
- 需要记忆的参数量多到爆炸(比地球上沙子还多),导致维度灾难(Curse of Dimensionality)
CNN的做法:让外星人直接看图,先看耳朵形状,再看眼睛位置,最后拼起来判断——这才是"看图"的正确姿势。
二、CNN四大核心组件(形象比喻)
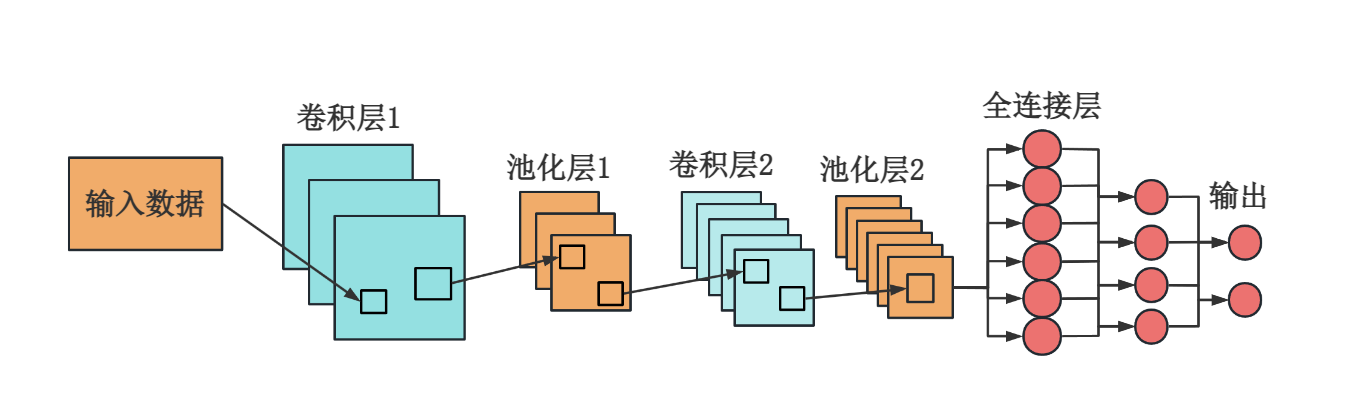
1. 卷积层(Convolutional Layer)—— "刷脸打卡"
形象比喻:想象你是公司保安,手里有一本员工照片册(卷积核/滤波器),每页是一个人的脸。在人群中滑动比对(滑动窗口),匹配成功则标记(激活)。
专业本质: 卷积是数学上的互相关运算(Cross-correlation),对于输入特征图 和卷积核 ,输出特征图 的计算为:
操作过程:
- 盯着照片册第一页(比如"张三的脸")→ 对应卷积核(Convolution Kernel / Filter)
- 目光在排队人群脸上扫过,看谁能对上 → 滑动窗口(Sliding Window)机制
- 对上了就打个勾(激活),没对上略过 → 生成特征图(Feature Map / Activation Map)
- 翻页看李四,再扫一遍人群 → 多通道(Multi-Channel)卷积
专业细节:
- 感受野(Receptive Field):每次只看局部区域(如3×3像素)
- 步长(Stride):每次滑动的距离
- 填充(Padding):在边缘补零,防止信息丢失
- 权重共享(Weight Sharing):同一个卷积核扫遍全图,大幅减少参数量
为什么有效? 无论张三站在队伍最前还是最后,同一张照片都能把他"认"出来!这就是平移不变性(Translation Invariance)。
2. 激活函数(Activation Function)—— "把灯打开"
卷积计算后,我们会得到有正有负的数字。ReLU(Rectified Linear Unit,线性整流函数)的做法简单粗暴:负数变0,正数保持不变。
💡 电路比喻:就像家里的开关——有电(正数)就亮灯,没电(负数)就保持黑暗。这样网络只关注"有信号"的地方,忽略噪音。
其他常见激活函数:
- Sigmoid:将输出压缩到(0,1),适合概率输出
- Tanh:将输出压缩到(-1,1),均值为0
-
Leaky ReLU:负数部分保留微小斜率,防止神经元死亡(Dead ReLU)
-
Softmax(用于多分类输出层):
核心作用:引入非线性(Non-linearity),让网络能学习复杂模式。没有激活函数,多层网络等价于单层线性变换。
3. 池化层(Pooling Layer)—— "抓大放小"
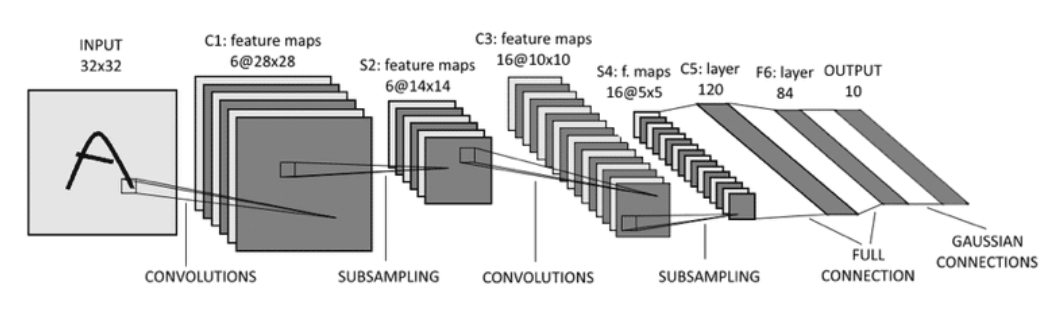
最常见的最大池化(Max Pooling),在一个2×2的池化窗口里,只留最大的那个数,其他三个扔掉。
专业参数:
- 池化尺寸(Pool Size):如2×2、3×3
- 步长(Stride):通常等于池化尺寸,实现下采样(Downsampling)
🏆 比赛比喻:四个选手比赛,只让冠军晋级,其他淘汰。这样每轮过后,"选手"数量减半,但留下的都是精英。
核心思想:
- 特征不变性(Feature Invariance):精确位置不重要,有没有这个特征才重要。猫的眼睛在(100,100)还是(102,98),不影响它是猫的事实。
- 降维(Dimensionality Reduction):减少计算量,防止过拟合(Overfitting)
其他池化方式:
- 平均池化(Average Pooling):取平均值,保留更多背景信息
- 全局平均池化(Global Average Pooling, GAP):整张图池化成一个数,替代全连接层
4. 全连接层(Fully Connected Layer / Dense Layer)—— "终审判决"
经过多层卷积和池化,图片被压缩成一串特征向量(Feature Vector),比如:
- [有尖耳朵: 0.9, 有圆眼睛: 0.85, 有胡须: 0.8, 有长尾巴: 0.7...]
全连接层就像法官综合证据:
- 陪审员1:"尖耳朵+圆眼睛,像猫科动物" → 投"猫"一票
- 陪审员2:"体型小+家养特征,不像老虎" → 排除大猫
- 陪审员3:"胡须特征明显" → 加强"猫"的判断
最终统计票数,得票最多的类别胜出!这就是Softmax分类输出概率分布(Probability Distribution)。
专业细节:
- 前向传播(Forward Propagation):从输入到输出的计算过程
- 损失函数(Loss Function):如交叉熵损失(Cross-Entropy Loss),衡量预测与真实的差距
- 反向传播(Backpropagation):通过链式法则计算梯度 ,采用梯度下降(SGD/Adam)更新权重:
正则化技术:
- Dropout:训练时随机置零部分神经元,防止共适应
- L2正则化:惩罚大权值,
- 批归一化(Batch Normalization):标准化层输入,加速收敛,允许更高学习率
三、CNN的"视觉成长史"(层级特征学习)
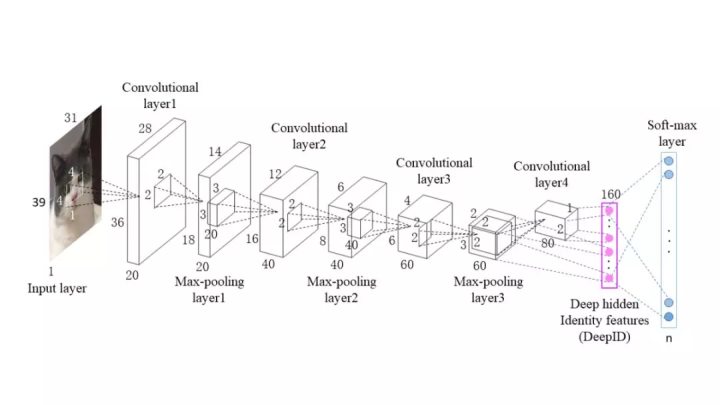
原始图片:一只猫在草地上
    ↓
[第一层卷积] 🔍  低层特征(Low-Level Features)
像新生儿看世界:只能感知"亮暗边缘"和"颜色块"
→ 输出:边缘检测(Edge Detection)、颜色梯度(Color Gradient)
    ↓
[第二层卷积] 🔍🔍  中层特征(Mid-Level Features)
像幼儿学画画:能把线条组合成"形状"
→ 输出:纹理(Texture)、轮廓(Contour)、耳朵/眼睛形状
    ↓
[第三层卷积] 🔍🔍🔍  高层特征(High-Level Features)
像小学生认图:能识别"部件"
→ 输出:部件(Parts)检测器——耳朵检测器、眼睛检测器、鼻子检测器
    ↓
[第四层及更深] 🔍🔍🔍🔍  语义特征(Semantic Features)
像成年人观察:能识别"整体概念"
→ 输出:对象(Object)表示——"猫"的完整概念嵌入(Embedding)
    ↓
[全连接层] ⚖️  分类决策(Classification)
像专家鉴定:综合判断"这是猫,不是狗,置信度98%"
→ 输出:对数几率(Logits) → Softmax概率
🧠 神经科学呼应:这和人脑视觉皮层(Visual Cortex)的工作方式几乎一致!从V1区(初级视觉皮层,检测边缘)到IT区(颞下皮层,识别物体),大自然和工程师想到了一块儿。这就是仿生学(Bionics)的力量。
四、CNN的三大"超能力"(核心特性)
| 超能力 | 专业术语 | 通俗解释 | 生活类比 |
|---|---|---|---|
| 局部感知 | 局部连接(Local Connectivity) | 不看整体,先看局部 | 中医"望闻问切",先看舌苔、再摸脉象,最后综合 |
| 权重共享 | 参数共享(Parameter Sharing) | 同一个工具到处用 | 用同一把尺子量遍全屋家具,不用每量一次换把新尺子 |
| 平移不变 | 平移不变性(Translation Invariance) | 物体在哪都能认 | 你朋友站在教室左边或右边,你都认得出来 |
额外优势:
- 稀疏连接(Sparse Connectivity):相比全连接,参数量减少90%以上
- 端到端学习(End-to-End Learning):自动学习特征,无需特征工程(Feature Engineering)
五、CNN在现实中的应用
| 应用场景 | CNN在做什么 | 背后的技术/比喻 |
|---|---|---|
| 手机人脸解锁 | 提取你脸上128维特征嵌入(Face Embedding) | 像机场安检比对护照照片,用余弦相似度(Cosine Similarity)判断是否同一人 |
| 医学CT看肿瘤 | 识别异常组织纹理,进行语义分割(Semantic Segmentation) | 像老练的放射科医师看片,用U-Net架构定位病灶 |
| 自动驾驶认路标 | 实时目标检测(Object Detection),输出边界框(Bounding Box) | 像飞行员扫视仪表盘,用YOLO或R-CNN系列算法 |
| 抖音推荐封面 | 分析视频内容打标签,进行多标签分类(Multi-Label Classification) | 像图书管理员给书分类,用迁移学习(Transfer Learning)快速适配 |
| 美颜相机磨皮 | 风格迁移(Style Transfer)、生成对抗网络(GAN) | 像数字化妆师,用Pix2Pix或CycleGAN技术 |
六、经典CNN架构演进史
| 年份 | 网络 | 核心创新 | 意义 |
|---|---|---|---|
| 1998 | LeNet-5 | 奠定CNN基础结构 | 手写数字识别,商用成功 |
| 2012 | AlexNet | ReLU + Dropout + GPU训练 | ImageNet冠军,开启深度学习热潮 |
| 2014 | VGGNet | 小卷积核(3×3)堆叠,网络加深到16-19层 | 证明"深度"的重要性 |
| 2015 | ResNet | 残差连接(Residual Connection),突破100+层 | 解决梯度消失(Vanishing Gradient)问题 |
| 2016 | DenseNet | 密集连接(Dense Connection),特征复用 | 参数更少,性能更好 |
| 2017 | MobileNet | 深度可分离卷积(Depthwise Separable Convolution) | 轻量化,适合移动端 |
| 2019 | EfficientNet | 复合缩放(Compound Scaling),平衡深度/宽度/分辨率 | 效率最优的标杆 |
七、一句话记住CNN
CNN = 卷积提取局部特征(Convolution)+ 激活引入非线性(ReLU)+ 池化降维保不变(Pooling)+ 全连接做决策(FC)
它教会了计算机:不要一口吃成胖子,先看局部,再拼整体——这才是"看懂"世界的正确方式。
八、动手试试
想直观感受卷积?打开你的手机相册,使用"轮廓"或"素描"滤镜——那就是一个简单的Sobel算子(边缘检测卷积核)在起作用!
边缘检测滤镜让照片看起来像漫画,和CNN第一层做的事情一模一样。🎯