概述
我们写程序时看到的是 print("Hello, world!"),处理器接触到的却不是这行文字本身,而是按照硬件和软件约定编码的数据与指令。从电路中的电压状态,到内存里的字节,再到编译器生成的机器指令和磁盘上的文件,中间经过了多层转换。
理解这条链路,关键不在于把所有东西都想成一串神秘的 0 和 1,而是追问:是谁规定这些位代表什么?谁负责按照这套规则读取它们?
本文从四个层次展开:
- 电路怎样稳定地区分两种状态;
- 位和字节怎样被解释成数字、文字和其他数据;
- 源程序怎样经过编译或运行时成为可执行的指令;
.bin文件可能包含什么,以及它为什么没有统一含义。
一、电路如何表示 0 和 1
现代计算机由大量晶体管和其他电子元件组成。晶体管可以控制电流,在数字电路中被组合成逻辑门、寄存器和存储单元。电路设计会把一定范围的电压识别为逻辑低电平,另一个范围识别为逻辑高电平,再分别记作 0 和 1。
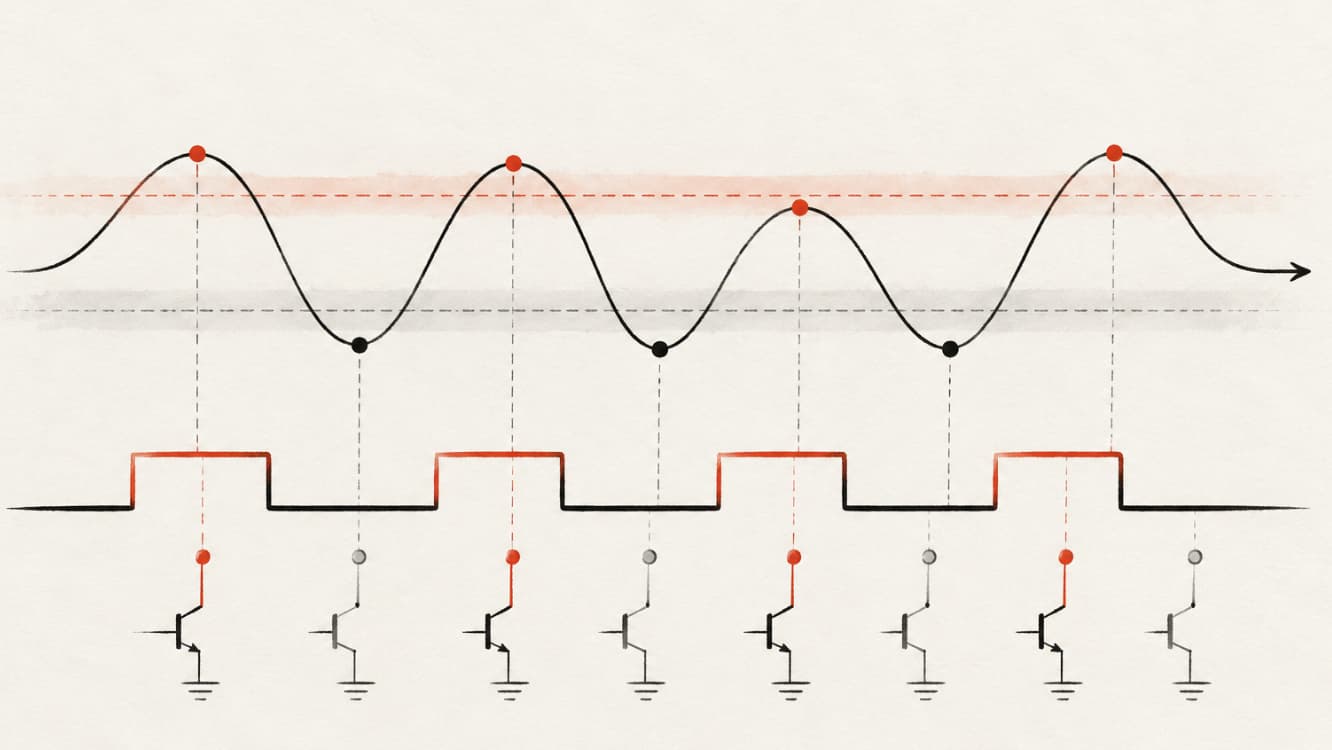
这不是说电路里真的存在一个写着“0”或“1”的小开关,也不是说每个状态都必须对应恰好为零或某个固定值的电压。电路有噪声、延迟和容差,因此硬件规范会定义可接受的电压范围,并留出安全余量,让相邻电路能够可靠地判断状态。
可以把它简化成下面的模型:
低电压范围  → 逻辑 0
高电压范围  → 逻辑 1
一个二进制位(bit)表达两种状态之一。8 个 bit 组成一个字节(byte),可组合出 256 种不同模式:
00000000 = 0
00000001 = 1
00000010 = 2
...
11111111 = 255
这里的 0 到 255 是一种解释方式:把 8 位按无符号整数读取。
相同的 8 个 bit,也可以被解释成有符号整数的一部分、一个字符、颜色分量或机器指令。如果采用一种叫作补码的规则,把 8 位解释成有符号整数,范围就变成了 -128~127。你会发现,11111111 没有变化。
-
按无符号规则,它表示
255。 -
按 8 位补码规则,它表示
-1。
这不是计算机把数据改了,而是我们换了一套解释规则。所以说位负责保存状态,含义来自约定。你可以把它理解为三件事:
- 位(bit):只负责记录 0 或 1。
- 编码规则:规定怎样把一组位解释成数字、文字等。
- 程序:按照相应规则读取和处理这些位。
二、同一组位为什么能表示不同东西
数字:位置决定权重
在无符号二进制计数中,从右向左每一位依次对应 2 的 0 次方、2 的 1 次方、2 的 2 次方……因此:
00000101
= 0×128 + 0×64 + 0×32 + 0×16
  + 0×8 + 1×4 + 0×2 + 1×1
= 5
但如果解释规则变成补码有符号整数、浮点数或定点数,同样的位模式就可能有另一种数值含义。读数据时不能只问“字节是什么”,还要问“数据类型和编码规则是什么”。
文字:编码把字符映射为数值
字符编码规定文字如何变成字节。例如,ASCII 中的大写字母 A 对应十进制 65,写成一个 8 位字节就是 01000001。UTF-8 则用可变长度的字节序列编码 Unicode 字符,既兼容 ASCII 的基本范围,也能表示多种语言。
因此,文件里的字节不会天然带着“这是汉字”或“这是字母”的标签。程序必须使用正确的字符编码去解码;规则不匹配时,就会出现乱码或解码错误。
图像和声音:格式定义数据组织方式
图片通常要把像素值、尺寸、颜色空间、压缩方式等信息组织起来;音频需要描述采样率、声道、样本格式和可能的压缩方式。单独一段字节不足以告诉程序它是一张图片还是一段声音。格式规范和文件中的元数据共同提供解释依据。
这也说明了一个更深的区别:数据不是意义本身,数据只有进入解释规则,才成为对程序有用的信息。
三、程序如何从源代码走到机器指令
源代码是为人设计的表达方式。对于常见的 C 或 C++ 编译流程,可以简化为:
源代码
   ↓ 预处理、编译、汇编
目标文件(机器指令、数据及符号信息)
   ↓ 链接
可执行文件
   ↓ 操作系统加载
进程的内存映像
   ↓ 处理器取指、译码、执行
程序运行
编译器会根据目标处理器、操作系统和编译选项生成目标代码。链接器将程序自身的目标文件与所需的库组合起来,并处理符号引用等关系。可执行文件通常还包含操作系统需要的结构信息,例如代码段、数据段、入口点和依赖信息。
flowchart TD
    A["源代码<br/>例如 main.c"] --> B["编译器<br/>语法检查、优化、生成目标代码"]
    B --> C["目标文件<br/>机器指令、数据、符号信息"]

    D["库文件<br/>程序依赖的功能"] --> E["链接器"]
    C --> E

    E --> F["可执行文件<br/>代码段、数据段、入口点、依赖信息"]
    F --> G["操作系统加载器"]
    G --> H["建立进程内存映像<br/>装载程序、处理必要的依赖"]

    H --> I["CPU 处理器"]
    I --> J["取指令"]
    J --> K["指令译码"]
    K --> L["执行指令"]
    L --> M{"程序是否继续运行?"}

    M -- 是 --> J
    M -- 否 --> N["程序结束"]

    classDef source fill:#E8F1FF,stroke:#4678C8,color:#172B4D
    classDef compile fill:#E5F5E9,stroke:#39945B,color:#163B26
    classDef runtime fill:#FFF1DB,stroke:#C78B35,color:#563B16
    classDef cpu fill:#F1E8FF,stroke:#9063C7,color:#39245A

    class A,C,F source
    class B,D,E compile
    class G,H runtime
    class I,J,K,L cpu
程序启动时,操作系统的加载器会读取可执行文件,建立进程所需的内存映像,并完成必要的装载与链接工作。处理器随后从合适的地址取出机器指令,按照自己的指令集解码并执行。也就是说,处理器通常不会把磁盘上的整个文件原封不动地“当作程序跑起来”。
这也是跨平台兼容性产生的原因之一:不同处理器可能使用不同指令集,不同操作系统可能采用不同可执行文件格式和调用约定。一个文件即使同样由字节构成,也不代表另一台机器知道如何加载和执行它。
不同语言还会采用不同的执行路径:
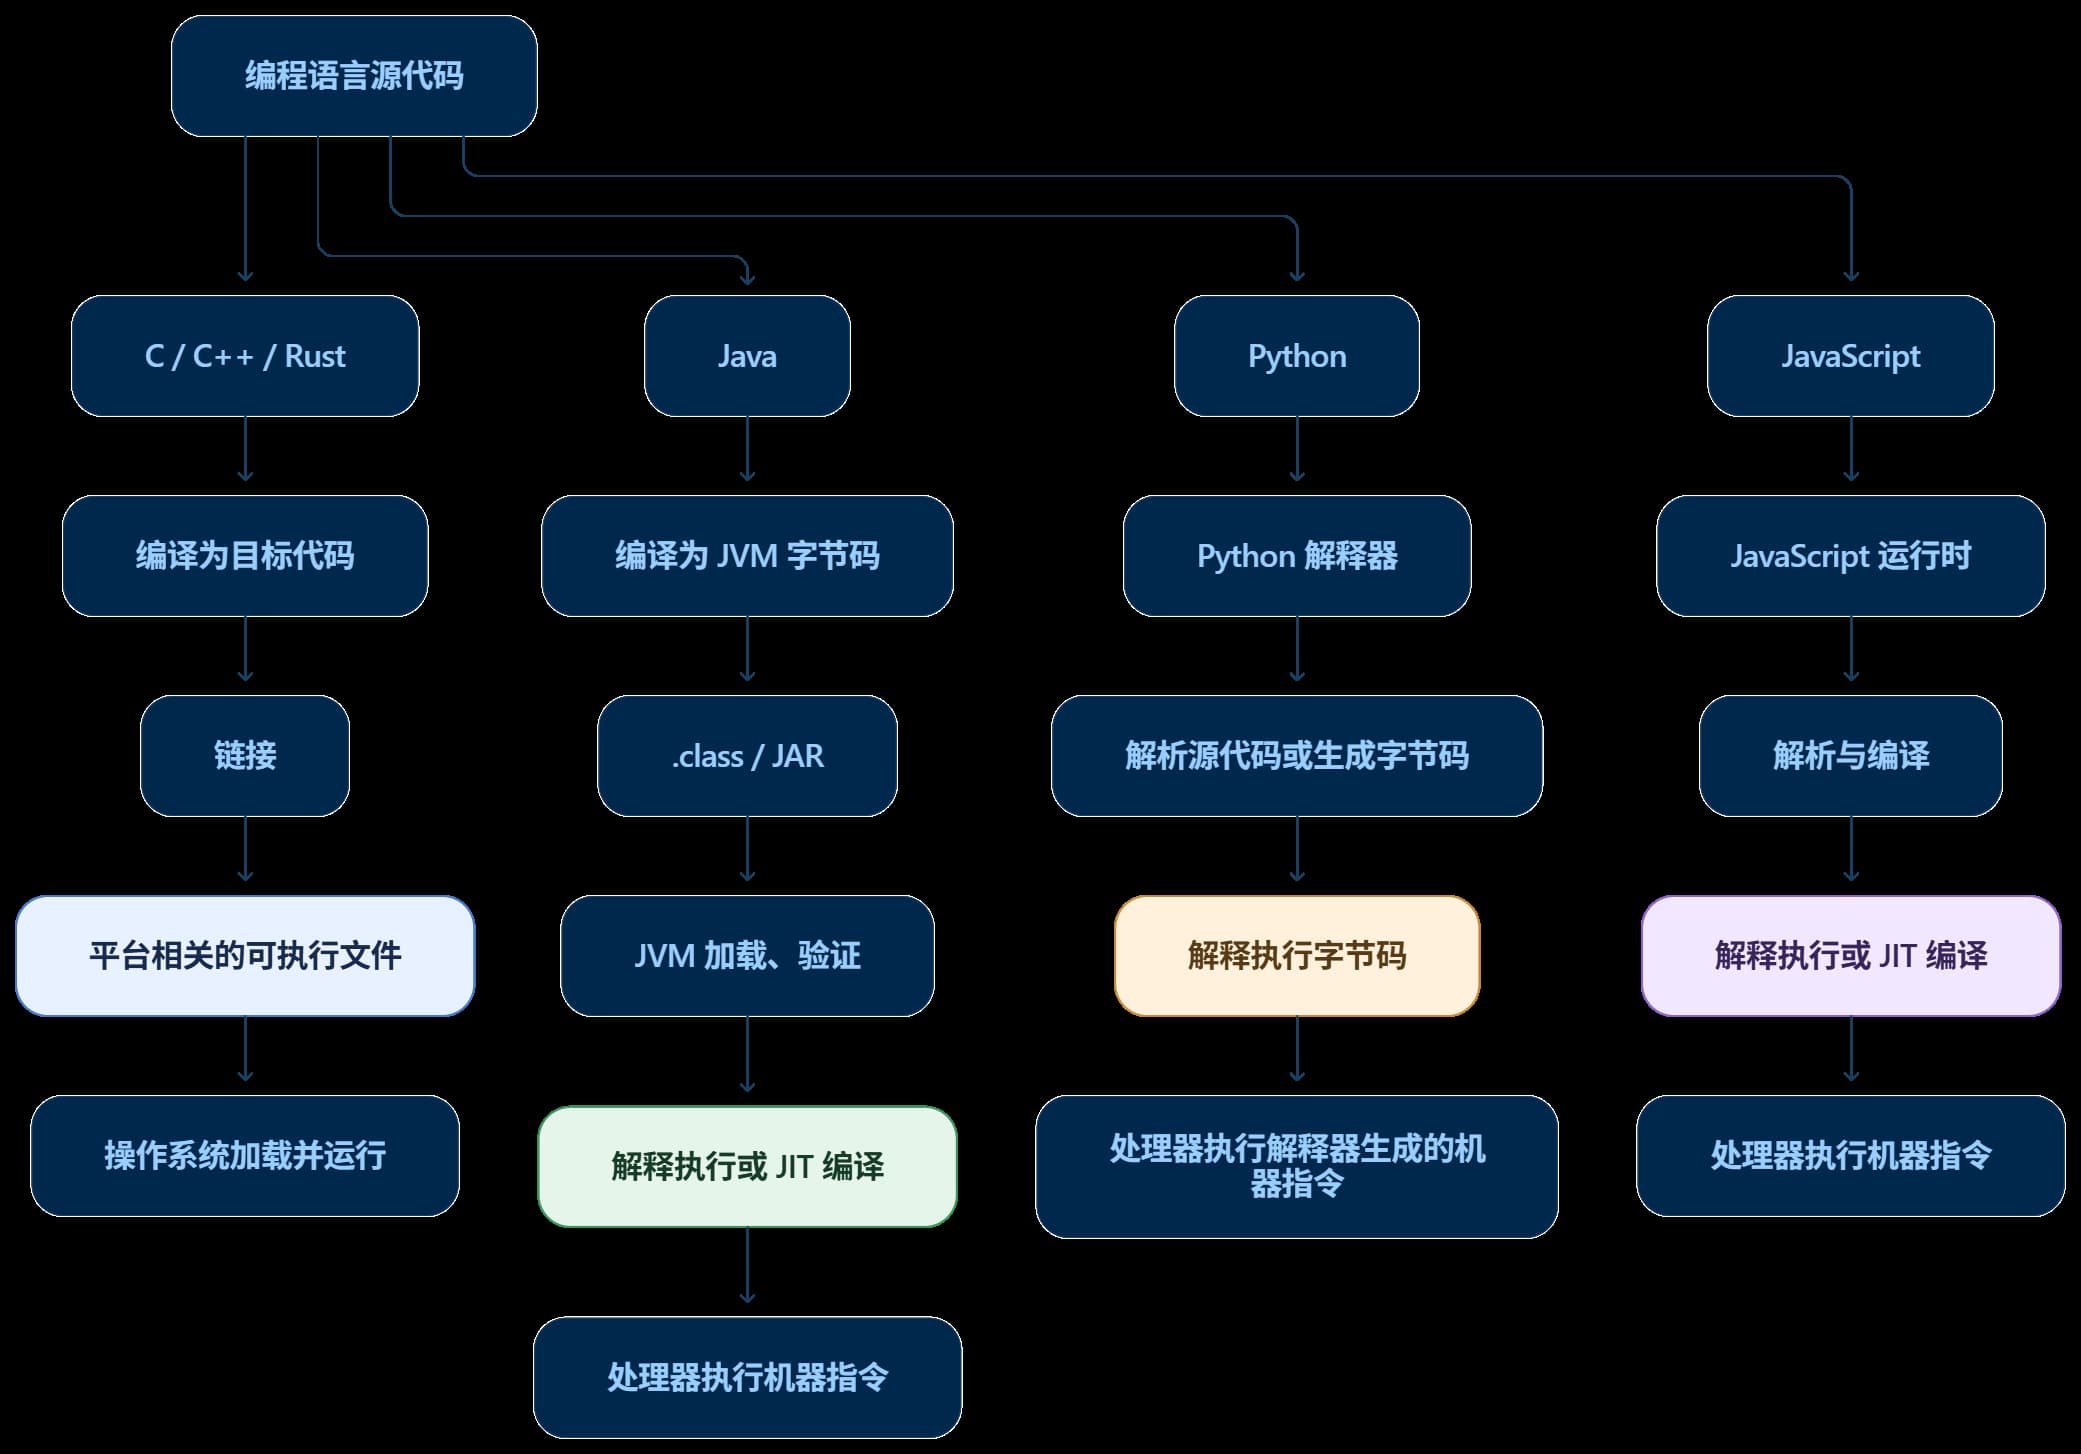
所以,“程序变成二进制”不是一条对所有语言都完全相同的流水线。更准确地说,源代码经过编译器、解释器或运行时处理,以适合目标环境的表示方式被执行。
四、.bin 文件究竟是什么
.bin 通常是 binary(二进制)的缩写,但这个扩展名本身并没有规定统一的文件格式。它只是一个命名提示,告诉我们文件可能以二进制数据保存,却无法单独说明数据结构、用途或读取方式。
.bin 文件可能包含:
- 可由特定处理器执行的机器码;
- 路由器、单片机或其他设备使用的固件镜像;
- 启动阶段读取的数据;
- 压缩后的图片、音频或其他资源;
- 由某个软件按私有约定组织的记录、参数或索引。
有些二进制格式带有文件头,用于描述类型、版本、长度或校验信息;有些格式还会包含目录、偏移量、索引或多个数据块。裸固件镜像则可能没有通用的文件头,写入设备时要依赖外部约定,例如烧录地址、芯片型号和引导程序的预期布局。
因此,判断一个 .bin 文件是什么,通常要结合它的来源、生成工具、目标设备和配套文档。扩展名可以提供线索,却不是格式规范。用文本编辑器打开看到乱码也很正常:文本编辑器只是在尝试把任意字节映射为字符,而文件内容未必是文字。
五、二进制文件不等于“写着 0 和 1 的文本”
很多人会以为,二进制文件就是把一串 0 和 1 保存到文件里。其实,**二进制文件保存的是字节,而不是必须由字符 0 和 1 组成的文本。我们用数字 5 举个例子。
情况一:保存数值 5
二进制位:00000101
占用空间:1 个字节
这里的 00000101 是对一个字节的二进制表示。计算机将它按无符号整数解释时,得到的数值就是 5。
情况二:保存文本 "00000101"
文本内容:00000101
占用空间:8 个字节
这里保存的是 8 个字符:4 个字符 0、1 个字符 1,再加上另外 3 个字符。使用 ASCII 或 UTF-8 编码时,每个字符占 1 个字节,因此总共占用 8 个字节。
两者的区别在于:
- 数值 5:保存的是表示数字 5 的一个字节。
- 文本
"00000101":保存的是 8 个字符,用来描述一串二进制数字。
虽然它们看起来都与 00000101 有关,但实际存储的字节数量和内容都不同。
同一个文件,为什么用不同工具打开会看到不同内容?
因为不同工具会按照不同的规则解释字节。
- 文本编辑器:尝试把字节解码成文字。
- 十六进制查看器:把每个字节显示成
00到FF之间的十六进制数。 - 反汇编器:按照指定处理器的指令集,尝试把字节解释成机器指令。
例如,一个字节 01000001,用十六进制查看器会显示为 41;如果按照 ASCII 编码解读,则对应字符 A。需要注意,反汇编器也不是万能的:如果数据本身不是机器指令,或者选错了处理器指令集,就可能得到没有意义的结果。
记住:文件中的字节是实际保存的数据,工具显示的文字、数字或指令则是按照特定规则得到的解释。改变查看工具,不会改变文件本身,只会改变我们观察和理解它的方式。
六、从二进制理解计算机的抽象
flowchart TD
    A["物理层:电路与电压<br/>电路将电压状态识别为逻辑 0 和 1"]
    B["数据层:位与编码<br/>按照规则将位解释为数字、文字、图像等"]
    C["程序层:编译与运行时<br/>将程序转换为目标环境能够执行的指令"]
    D["文件层:文件格式与协议<br/>规定字节如何组织、存储和读取"]
    E["应用层:软件与硬件设备<br/>按照约定解析数据并完成具体任务"]

    A --> B
    B --> C
    C --> D
    D --> E

    A1["电压范围"]
    B1["数据类型、字符编码"]
    C1["指令集、编译规则"]
    D1["文件结构、字段定义"]
    E1["操作系统、应用程序、设备固件"]

    A -.-> A1
    B -.-> B1
    C -.-> C1
    D -.-> D1
    E -.-> E1

    F["核心思想:底层保存状态,上层通过规则赋予其含义"]
    E --> F

    style A fill:#E8F1FF,stroke:#4678C8,color:#172B4D
    style B fill:#E5F5E9,stroke:#39945B,color:#163B26
    style C fill:#FFF1DB,stroke:#C78B35,color:#563B16
    style D fill:#F1E8FF,stroke:#9063C7,color:#39245A
    style E fill:#E8F1FF,stroke:#4678C8,color:#172B4D
    style F fill:#F3F4F6,stroke:#6B7280,color:#111827
这带来一个值得记住的结论:计算机并不是凭空“理解”数据,而是在遵守一套层层叠加的规则。所谓可执行文件、图片或固件,并不是字节天然拥有的身份;它们是特定软硬件生态对这些字节达成的约定。能否互通,取决于双方是否共享这套约定。
小结
电路通过电压范围表示逻辑 0 和 1,多个 bit 组成字节;编码和数据类型决定这些位被解释成数字、文字、图像还是其他信息。程序再经由编译器、链接器或运行时,转化为目标环境能够加载和执行的形式。
.bin 只是一种宽泛的扩展名,不定义统一内容。要真正读懂它,需要知道它的来源、格式约定和目标程序。理解二进制,最终不是背下更多 0 和 1,而是学会识别每一层中负责赋予数据含义的规则。