什么是机器学习
数据 + 模型 + 预测
数据集构成:特征值 + 目标值
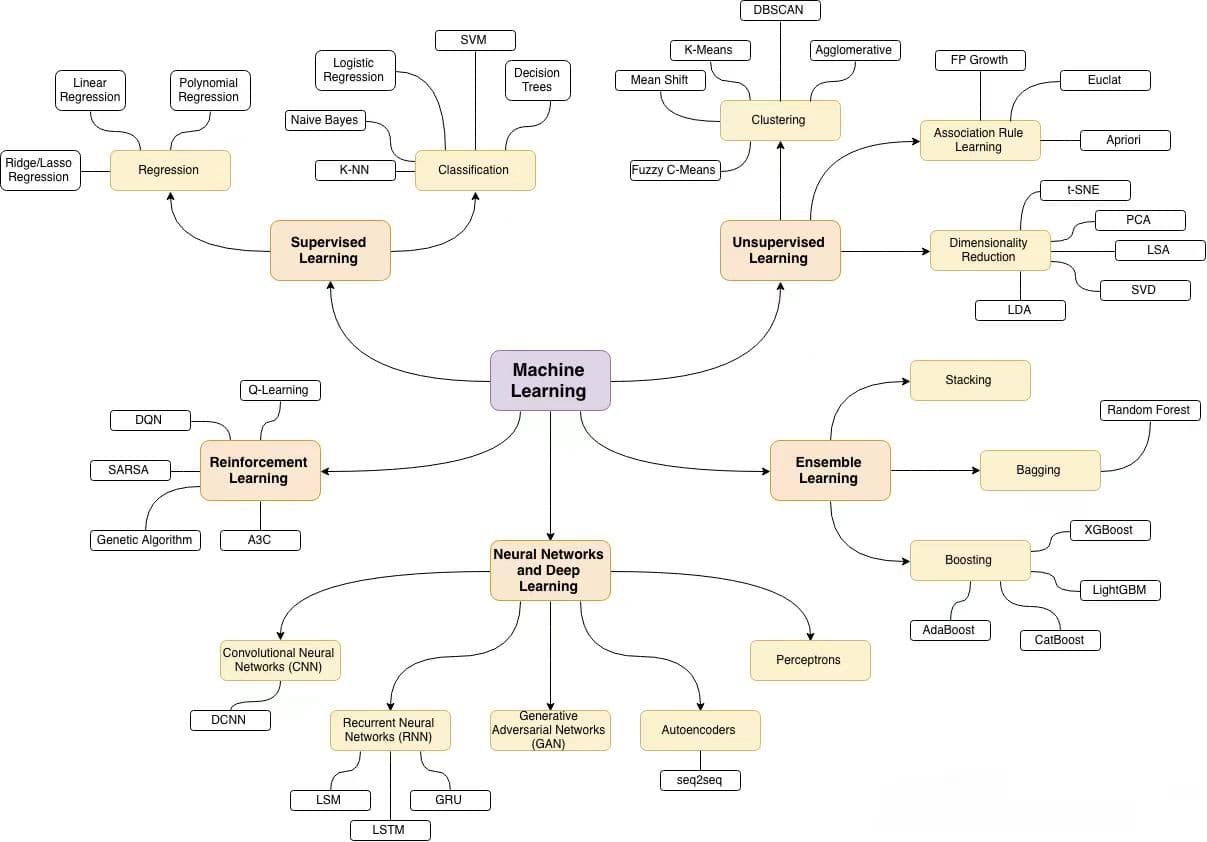
机器学习算法分类
机器学习开发流程: 1)获取数据 2)数据处理 3)特征工程 4)机器学习算法训练 - 模型 5)模型评估 6)应用
sklearn数据集
- sklearn.datasets
load_*  获取小规模数据集
fetch_* 获取大规模数据集
- sklearn小数据集
sklearn.datasets.load_iris()
- sklearn大数据集
sklearn.datasets.fetch_20newsgroups(data_home=None,subset=‘train’)
- 数据集的返回值
datasets.base.Bunch(继承自字典)
    dict["key"] = values
    bunch.key = values
数据集的划分
训练数据:用于训练,构建模型 测试数据:在模型检验时使用,用于评估模型是否有效,测试集 20%~30%
sklearn.model_selection.train_test_split(arrays, *options)
训练集特征值,测试集特征值,训练集目标值,测试集目标值
- x_train, x_test, y_train, y_test
特征工程介绍
特征提取
sklearn.feature_extraction
字典特征提取 - 类别 -> one-hot编码
sklearn.feature_extraction.DictVectorizer(sparse=True,…)
vector 数学:向量 物理:矢量
矩阵 matrix 二维数组 向量 vector 一维数组
父类:转换器类
返回sparse矩阵, sparse稀疏
- 将非零值 按位置表示出来 ---> 节省内存 - 提高加载效率
应用场景:
1)pclass, sex 数据集当中类别特征比较多
1、将数据集的特征 -》字典类型 2、DictVectorizer转换
2)本身拿到的数据就是字典类型
文本特征提取
单词 作为 特征
句子、短语、单词、字母
- 特征:特征词
方法1:CountVectorizer
关键词:在某一个类别的文章中,出现的次数很多,但是在其他类别的文章当中出现很少
方法2:TfidfVectorizer
什么是特征预处理
归一化
通过对原始数据进行变换把数据映射到(默认为[0,1])之间
异常值:最大值、最小值
标准化
- (x - mean) / std
标准差:集中程度
应用场景:在已有样本足够多的情况下比较稳定,适合现代嘈杂大数据
降维 - 降低维度
- ndarray
维数:嵌套的层数 0维 标量 1维 向量 2维 矩阵 3维 n维
二维数组 此处的降维:降低特征的个数 效果:特征与特征之间不相关
降维
- 特征选择
- Filter过滤式
方差选择法:低方差特征过滤
相关系数 - 特征与特征之间的相关程度 取值范围:–1 ≤ r ≤ +1 皮尔逊相关系数:0.9942
特征与特征之间相关性很高:
1)选取其中一个 2)加权求和 3)主成分分析
- Embeded嵌入式
决策树 正则化 深度学习
- 主成分分析
什么是主成分分析(PCA)
sklearn.decomposition.PCA(n_components=None)
- n_components
小数 表示保留百分之多少的信息 整数 减少到多少特征
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.feature_extraction import DictVectorizer
from sklearn.feature_extraction.text import CountVectorizer, TfidfVectorizer
from sklearn.preprocessing import MinMaxScaler, StandardScaler
from sklearn.feature_selection import VarianceThreshold
from sklearn.decomposition import PCA
from scipy.stats import pearsonr
import jieba
import pandas as pd


def datasets_demo():
    """
    sklearn数据集使用
    :return:
    """
    # 获取数据集
    iris = load_iris()
    print("鸢尾花数据集:\n", iris)
    print("查看数据集描述:\n", iris["DESCR"])
    print("查看特征值的名字:\n", iris.feature_names)
    print("查看特征值:\n", iris.data, iris.data.shape)

    # 数据集划分
    x_train, x_test, y_train, y_test = train_test_split(iris.data, iris.target, test_size=0.2, random_state=22)
    print("训练集的特征值:\n", x_train, x_train.shape)

    return None


def dict_demo():
    """
    字典特征抽取
    :return:
    """
    data = [{'city': '北京','temperature':100}, {'city': '上海','temperature':60}, {'city': '深圳','temperature':30}]
    # 1、实例化一个转换器类
    transfer = DictVectorizer(sparse=True)

    # 2、调用fit_transform()
    data_new = transfer.fit_transform(data)
    print("data_new:\n", data_new.toarray(), type(data_new))
    print("特征名字:\n", transfer.get_feature_names())

    return None


def count_demo():
    """
    文本特征抽取:CountVecotrizer
    :return:
    """
    data = ["life is short,i like like python", "life is too long,i dislike python"]
    # 1、实例化一个转换器类
    transfer = CountVectorizer(stop_words=["is", "too"])

    # 2、调用fit_transform
    data_new = transfer.fit_transform(data)
    print("data_new:\n", data_new.toarray())
    print("特征名字:\n", transfer.get_feature_names())

    return None

def count_chinese_demo():
    """
    中文文本特征抽取:CountVecotrizer
    :return:
    """
    data = ["我 爱 北京 天安门", "天安门 上 太阳 升"]
    # 1、实例化一个转换器类
    transfer = CountVectorizer()

    # 2、调用fit_transform
    data_new = transfer.fit_transform(data)
    print("data_new:\n", data_new.toarray())
    print("特征名字:\n", transfer.get_feature_names())

    return None


def cut_word(text):
    """
    进行中文分词:"我爱北京天安门" --> "我 爱 北京 天安门"
    :param text:
    :return:
    """
    return " ".join(list(jieba.cut(text)))


def count_chinese_demo2():
    """
    中文文本特征抽取,自动分词
    :return:
    """
    # 将中文文本进行分词
    data = ["一种还是一种今天很残酷,明天更残酷,后天很美好,但绝对大部分是死在明天晚上,所以每个人不要放弃今天。",
            "我们看到的从很远星系来的光是在几百万年之前发出的,这样当我们看到宇宙时,我们是在看它的过去。",
            "如果只用一种方式了解某样事物,你就不会真正了解它。了解事物真正含义的秘密取决于如何将其与我们所了解的事物相联系。"]

    data_new = []
    for sent in data:
        data_new.append(cut_word(sent))
    # print(data_new)
    # 1、实例化一个转换器类
    transfer = CountVectorizer(stop_words=["一种", "所以"])

    # 2、调用fit_transform
    data_final = transfer.fit_transform(data_new)
    print("data_new:\n", data_final.toarray())
    print("特征名字:\n", transfer.get_feature_names())

    return None

def tfidf_demo():
    """
    用TF-IDF的方法进行文本特征抽取
    :return:
    """
    # 将中文文本进行分词
    data = ["一种还是一种今天很残酷,明天更残酷,后天很美好,但绝对大部分是死在明天晚上,所以每个人不要放弃今天。",
            "我们看到的从很远星系来的光是在几百万年之前发出的,这样当我们看到宇宙时,我们是在看它的过去。",
            "如果只用一种方式了解某样事物,你就不会真正了解它。了解事物真正含义的秘密取决于如何将其与我们所了解的事物相联系。"]

    data_new = []
    for sent in data:
        data_new.append(cut_word(sent))
    # print(data_new)
    # 1、实例化一个转换器类
    transfer = TfidfVectorizer(stop_words=["一种", "所以"])

    # 2、调用fit_transform
    data_final = transfer.fit_transform(data_new)
    print("data_new:\n", data_final.toarray())
    print("特征名字:\n", transfer.get_feature_names())

    return None

def minmax_demo():
    """
    归一化
    :return:
    """
    # 1、获取数据
    data = pd.read_csv("dating.txt")
    data = data.iloc[:, :3]
    print("data:\n", data)

    # 2、实例化一个转换器类
    transfer = MinMaxScaler(feature_range=[2, 3])

    # 3、调用fit_transform
    data_new = transfer.fit_transform(data)
    print("data_new:\n", data_new)

    return None


def stand_demo():
    """
    标准化
    :return:
    """
    # 1、获取数据
    data = pd.read_csv("dating.txt")
    data = data.iloc[:, :3]
    print("data:\n", data)

    # 2、实例化一个转换器类
    transfer = StandardScaler()

    # 3、调用fit_transform
    data_new = transfer.fit_transform(data)
    print("data_new:\n", data_new)
    return None

def variance_demo():
    """
    过滤低方差特征
    :return:
    """
    # 1、获取数据
    data = pd.read_csv("factor_returns.csv")
    data = data.iloc[:, 1:-2]
    print("data:\n", data)

    # 2、实例化一个转换器类
    transfer = VarianceThreshold(threshold=10)

    # 3、调用fit_transform
    data_new = transfer.fit_transform(data)
    print("data_new:\n", data_new, data_new.shape)

    # 计算某两个变量之间的相关系数
    r1 = pearsonr(data["pe_ratio"], data["pb_ratio"])
    print("相关系数:\n", r1)
    r2 = pearsonr(data['revenue'], data['total_expense'])
    print("revenue与total_expense之间的相关性:\n", r2)

    return None


def pca_demo():
    """
    PCA降维
    :return:
    """
    data = [[2,8,4,5], [6,3,0,8], [5,4,9,1]]

    # 1、实例化一个转换器类
    transfer = PCA(n_components=0.95)

    # 2、调用fit_transform
    data_new = transfer.fit_transform(data)
    print("data_new:\n", data_new)
    return None

if __name__ == "__main__":
    # 代码1:sklearn数据集使用
    # datasets_demo()
    # 代码2:字典特征抽取
    # dict_demo()
    # 代码3:文本特征抽取:CountVecotrizer
    # count_demo()
    # 代码4:中文文本特征抽取:CountVecotrizer
    # count_chinese_demo()
    # 代码5:中文文本特征抽取,自动分词
    # count_chinese_demo2()
    # 代码6:中文分词
    # print(cut_word("我爱北京天安门"))
    # 代码7:用TF-IDF的方法进行文本特征抽取
    # tfidf_demo()
    # 代码8:归一化
    # minmax_demo()
    # 代码9:标准化
    # stand_demo()
    # 代码10:低方差特征过滤
    # variance_demo()
    # 代码11:PCA降维
    pca_demo()
sklearn转换器和估计器
-
转换器
-
估计器(estimator)
转换器 - 特征工程的父类
- 实例化 (实例化的是一个转换器类(Transformer))
- 调用fit_transform(对于文档建立分类词频矩阵,不能同时调用)
标准化: (x - mean) / std fit_transform() fit() 计算 每一列的平均值、标准差 transform() (x - mean) / std进行最终的转换
估计器(sklearn机器学习算法的实现)
估计器(estimator)
-
实例化一个estimator
-
estimator.fit(x_train, y_train) 计算
—— 调用完毕,模型生成
-
模型评估:
- 1)直接比对真实值和预测值
y_predict = estimator.predict(x_test)
y_test == y_predict
- 2)计算准确率
accuracy = estimator.score(x_test, y_test)
K-近邻算法
什么是K-近邻算法
KNN核心思想:你的“邻居”来推断出你的类别
- K-近邻算法(KNN)原理
k = 1 容易受到异常点的影响
如何确定谁是邻居?
计算距离:距离公式 欧氏距离 曼哈顿距离 绝对值距离 明可夫斯基距离
- 电影类型分析
k = 1 爱情片 k = 2 爱情片 …… k = 6 无法确定 k = 7 动作
-
如果取的最近的电影数量不一样?会是什么结果?
k 值取得过小,容易受到异常点的影响 k 值取得过大,样本不均衡的影响
-
结合前面的约会对象数据,分析K-近邻算法需要做什么样的处理
无量纲化的处理 标准化
sklearn.neighbors.KNeighborsClassifier(n_neighbors=5,algorithm='auto')
n_neighbors:k值
K-近邻总结
-
优点:简单,易于理解,易于实现,无需训练
-
缺点: 1)必须指定K值,K值选择不当则分类精度不能保证 2)懒惰算法,对测试样本分类时的计算量大,内存开销大
使用场景:小数据场景,几千~几万样本,具体场景具体业务去测试
模型选择与调优
什么是交叉验证(cross validation)
超参数搜索-网格搜索(Grid Search)
- k的取值 [1, 3, 5, 7, 9, 11] 暴力破解
鸢尾花案例增加K值调优
案例:预测facebook签到位置
流程分析:
- 获取数据
- 数据处理
- 目的: 特征值 x 目标值 y
a.缩小数据范围 2 < x < 2.5 1.0 < y < 1.5
b.time -> 年月日时分秒
c.过滤签到次数少的地点 数据集划分
- 特征工程:标准化
- KNN算法预估流程
- 模型选择与调优
- 模型评估
朴素贝叶斯算法
什么是朴素贝叶斯分类方法
概率基础
1 概率(Probability)定义
联合概率、条件概率与相互独立
联合概率:包含多个条件,且所有条件同时成立的概率 P(程序员, 匀称) P(程序员, 超重|喜欢) P(A, B)
条件概率:就是事件A在另外一个事件B已经发生条件下的发生概率 P(程序员|喜欢) P(程序员, 超重|喜欢) P(A|B)
相互独立: P(A, B) = P(A)P(B) <=> 事件A与事件B相互独立
朴素贝叶斯算法:朴素 + 贝叶斯
朴素贝叶斯算法总结
-
优点: 对缺失数据不太敏感,算法也比较简单,常用于文本分类。 分类准确度高,速度快
-
缺点: 由于使用了样本属性独立性的假设,所以如果特征属性有关联时其效果不好 我爱北京天安门
决策树
决策树分类原理详解
已知 四个特征值 预测 是否贷款给某个人 先看房子,再工作 -> 是否贷款 只看了两个特征 年龄,信贷情况,工作 看了三个特征
信息论基础
-
信息 香农:消除随机不定性的东西 小明 年龄 “我今年18岁” - 信息 小华 ”小明明年19岁” - 不是信息
-
信息的衡量 - 信息量 - 信息熵 bit g(D,A) = H(D) - 条件熵H(D|A)
决策树的划分依据之一------信息增益 没有免费的午餐
决策树可视化
决策树总结
- 优点: 可视化 - 可解释能力强
- 缺点: 容易产生过拟合
集成学习方法之随机森林
什么是集成学习方法
什么是随机森林
随机 森林:包含多个决策树的分类器
随机森林原理过程
训练集: N个样本 特征值 目标值 M个特征 随机 两个随机 训练集随机 - N个样本中随机有放回的抽样N个 bootstrap 随机有放回抽样 [1, 2, 3, 4, 5] 新的树的训练集 [2, 2, 3, 1, 5] 特征随机 - 从M个特征中随机抽取m个特征 M >> m 降维
总结
能够有效地运行在大数据集上, 处理具有高维特征的输入样本,而且不需要降维
回归和聚类
线性回归 欠拟合与过拟合 岭回归
分类算法:逻辑回归
模型保存与加载
无监督学习 K-means算法
线性回归
回归问题: 目标值 - 连续型的数据
线性回归的原理
主要原理是通过最小化预测值与实际值之间的误差平方和来寻找最佳拟合直线(或超平面)。
在线性回归中,通常假设特征和目标变量之间存在线性关系,即目标变量Y可以表示为特征X的线性组合加上一个常数项。这种关系可以用以下数学公式表示:
Y = wX + b 其中,Y是目标变量,X是特征向量,w是权重向量,b是偏置项。线性回归的目标就是找到最佳的w和b,使得预测值Y尽可能接近实际值。
为了找到最佳的w和b,线性回归采用了一种称为最小二乘法的优化算法。最小二乘法的基本思想是通过最小化预测值与实际值之间的误差平方和来寻找最佳拟合直线。具体来说,对于给定的训练数据集,线性回归会计算每个样本的预测值与实际值之间的误差,并将这些误差平方后求和,得到损失函数(也称为代价函数)。然后,通过最小化损失函数来更新w和b的值,使得预测值更加接近实际值。
最小二乘法通常采用梯度下降算法来实现。梯度下降算法是一种迭代优化算法,通过不断调整w和b的值来逐渐减小损失函数的值。具体来说,每次迭代中,算法会计算损失函数对w和b的梯度,然后根据梯度方向更新w和b的值,直到损失函数收敛到最小值。
线性回归的损失和优化原理(理解记忆)
目标:求模型参数 模型参数能够使得预测准确 真实关系:真实房子价格 = 0.02×中心区域的距离 + 0.04×城市一氧化氮浓度 + (-0.12×自住房平均房价) + 0.254×城镇犯罪率 随意假定:预测房子价格 = 0.25×中心区域的距离 + 0.14×城市一氧化氮浓度 + 0.42×自住房平均房价 + 0.34×城镇犯罪率 损失函数/cost/成本函数/目标函数: 最小二乘法 优化损失 优化方法? 正规方程 天才 - 直接求解W 拓展: 1) y = ax^2 + bx + c y' = 2ax + b = 0 x = - b / 2a 2) a * b = 1 b = 1 / a = a ^ -1 A * B = E [[1, 0, 0], [0, 1, 0], [0, 0, 1]] B = A ^ - 1 梯度下降 勤奋努力的普通人 试错、改进
欠拟合与过拟合
训练集上表现得好,测试集上不好 - 过拟合
什么是过拟合与欠拟合
欠拟合 学习到数据的特征过少 解决: 增加数据的特征数量
过拟合 原始特征过多,存在一些嘈杂特征, 模型过于复杂是因为模型尝试去兼顾各个测试数据点 解决: 正则化 L1 损失函数 + λ惩罚项 LASSO L2 更常用 损失函数 + λ惩罚项 Ridge - 岭回归
线性回归的改进-岭回归
带有L2正则化的线性回归-岭回归
alpha 正则化力度=惩罚项系数
分类算法-逻辑回归与二分类
逻辑回归的应用场景
广告点击率 是否会被点击 是否为垃圾邮件 是否患病 是否为金融诈骗 是否为虚假账号 正例 / 反例
逻辑回归的原理
线型回归的输出 就是 逻辑回归 的 输入 激活函数 sigmoid函数 [0, 1] 1/(1 + e^(-x)) 假设函数/线性模型 1/(1 + e^(-(w1x1 + w2x2 + w3x3 + …… + wnxn + b))) 损失函数 (y_predict - y_true)平方和/总数 逻辑回归的真实值/预测值 是否属于某个类别 对数似然损失 log 2 x 优化损失 梯度下降
分类的评估方法
1 精确率与召回率
1 混淆矩阵
    TP = True Possitive
    FN = False Negative
2 精确率(Precision)与召回率(Recall)
    精确率
    召回率 查得全不全
    工厂 质量检测 次品 召回率
3 F1-score 模型的稳健型
总共有100个人,如果99个样本癌症,1个样本非癌症 - 样本不均衡 不管怎样我全都预测正例(默认癌症为正例) - 不负责任的模型
准确率:99%
召回率:99/99 = 100%
精确率:99%
F1-score: 2*99%/ 199% = 99.497%
AUC:0.5
     TPR = 100%
     FPR = 1 / 1 = 100%
2 ROC曲线与AUC指标 1 知道TPR与FPR TPR = TP / (TP + FN) - 召回率 所有真实类别为1的样本中,预测类别为1的比例 FPR = FP / (FP + TN) 所有真实类别为0的样本中,预测类别为1的比例
模型保存和加载
无监督学习-K-means算法
什么是无监督学习
没有目标值 - 无监督学习
无监督学习包含算法
- 聚类
- K-means(K均值聚类)
- 降维
- PCA
Kmeans性能评估指标
轮廓系数
如果b_i>>a_i:趋近于1效果越好,b_i<<a_i:趋近于-1,效果不好。 轮廓系数的值是介于 [-1,1],越趋近于1代表内聚度和分离度都相对较优。
K-means总结
应用场景: 没有目标值 分类